
配对样本T检验
这个方法是做什么的
用来回答一个很具体的问题:同一批对象在两种条件下的测量值,平均而言有没有变化。
它不是把两列数字各自算个平均再比大小,而是先逐行相减得到“差值”,再检验这批差值的平均是不是 0——所以它真正分析的对象只有一列,就是差值。正因为分析的是差值,个体之间的底子差异被消掉了:底子好的人前后都高、底子差的人前后都低,这部分波动不进入误差。这就是配对设计比“把两列当成两批人来比”更灵敏的原因。
需要准备什么数据
- 变量1(定量型):至少 1 个,定量变量(数值)
- 变量2(定量型):至少 1 个,定量变量(数值)
数据要求
- 数据表至少 5 行。
- 单列缺失率不超过 20%。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
典型场景是“同一个对象量两次”或“一对一匹配”:
- 同一批患者治疗前 / 治疗后的评分
- 同一批门店改造前 / 改造后的月销售额
- 同一批被试在 A、B 两种界面下的任务完成时间
- 按年龄性别一比一匹配的病例组与对照组
判断标准只有一条:你能说清楚第 i 行的两个数为什么属于同一个对象。能说清楚就该用配对;说不清楚就不该用。
配对到底值不值得,第一张卡还给了一个直接的指标——这一对的配对相关 r。差值方差 = σ²x + σ²y − 2r·σx·σy,r 越大差值方差越小、检验效能越高;r 接近 0 甚至为负,说明配对没有起到控制个体差异的作用,那这个设计就白配了。
什么时候不要用它
- 两列数据其实来自不同的人——比如一列是 80 位男性的得分、另一列是 75 位女性的得分。这该用「独立样本T检验」。
- 测量了三次或更多次(基线、3 个月、6 个月)。反复做两两配对 t 检验会让假阳性膨胀,应改用「重复测量方差分析」。
- 差值明显偏态或含极端值,且样本量不大:改用「配对样本Wilcoxon检验」。第一张卡确实给了差值的 Shapiro-Wilk 与 Lilliefors 检验,但那不是“不过就换方法”的开关:小样本下它几乎检不出任何偏离,判成“满足”是必然结果;大样本下一点轻微偏斜也会被判成违反,而那恰恰是 t 检验最稳健的情形——两头都错。真正该看的是差值的偏度、直方图上有没有孤立的极端值,以及有效配对数;同一张卡自己也写着 n≥30 时均值的抽样分布近似正态、轻度偏离仍然稳健。
- 结果变量是等级或分类(如“差 / 一般 / 好”),做减法没有意义:等级数据只把差值当次序看,用「配对样本Wilcoxon检验」;前后各是一个二分类(是否达标)用「配对卡方检验」,三个及以上条件的二分类用「Cochran's Q 检验」。
容易误读的地方
- 配对是按行号配的,配错了系统不会报错。 本模块把两个拖拽区里同一行的两个数当作同一个对象的两次测量。如果你的数据在导出时按某一列排过序,或者两列的行顺序本来就来自不同的名单,算出来的差值就是一堆随机组合——检验照样会给出一个 t 值和 p 值,看不出任何异常。跑之前先确认两列是行对齐的。
- 差值的方向是“变量1 减 变量2”,不是“后减前”。 结果里出现负号只说明变量2那一列更大,不等于“下降”。先看清楚你把哪一列拖进了哪个区。
- p 值不是“两次测量没有差别的概率”,也不代表差别有多大。 它回答的是:假如总体上真的没有差别,单凭抽样波动看到当前这么大(或更大)的差值有多不容易。样本量足够大时,一个小到没有业务意义的差值也能做出 p 小于 0.001。差别有多大要看第四张卡的效应量,以及主结果表里差值的置信区间。
- Cohen's d_z 不能和独立样本的 Cohen's d 摆在一起比大小。 第四张卡给的 d_z = 差值均值 / 差值标准差 = t/√N,它的尺子是差值的离散度;独立样本 d 的尺子是合并的组内标准差。配对相关越高,差值标准差越小,同样的实际差距会换来一个大得多的 d_z(示例里均值差 −6.000、d_z = −0.955)。所以拿它去对照文献里独立样本设计的效应量、或者两种设计的 d 混着做元分析,都是错的。
- 前后有差异不等于干预起了作用。 单组前后测里,时间本身、被试熟悉了测验、以及“第一次测得特别低的人第二次自然会回升”(回归到均值)都能造出差异。要把差异归因于干预,需要对照组和随机分组,光靠这个检验做不到。
同一个差异,只把样本量从 20 加到 2000:效应量 Cohen's d 始终是 0.30,p 却从 0.35 掉到小于 0.001。p 变小说明「证据变足」,不说明「差异变大」——差多少要看效应量与它的置信区间。
左边是同一批对象测两次,分析的是每个人自己的差值,个体差异被抵消掉;右边是两拨不同对象各测一次,分析的是两组的整体水平,个体差异留在组内。数据是哪一种,决定了该用哪一族方法——摆错了不会报错,只会悄悄换掉你在检验的东西。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:配对样本 T 检验主结果表
- 输出结果三:配对差值分布可视化
- 输出结果四:效应量与多重比较校正
- 输出结果五:结论与学术表述
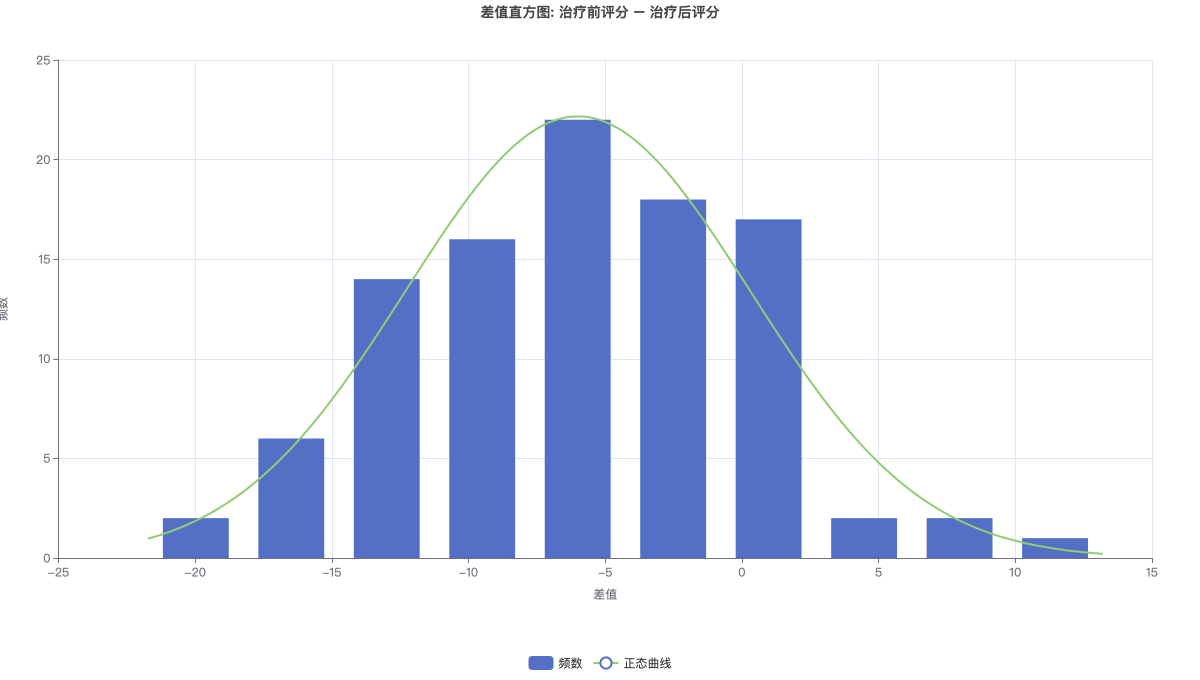
该图展示配对差值(治疗前评分 − 治疗后评分)的频数分布(蓝色柱),并叠加以差值均值 -6.000、标准差 6.284 为参数的理论正态曲线(绿线)供比对。本对差值的正态性检验结果:Shapiro-Wilk W = 0.993, p = 0.888。