
卡方检验
这个方法是做什么的
用来看两个分类变量之间有没有关联。做法是把它们交叉成一张列联表,比较每一格的实际人数,和“假如两个变量毫无关系时本该有的人数”(期望频数)差多少。差得越离谱,卡方值越大。
它回答的是“有没有关联”。关联有多强、来自哪一格,是另外两个问题,报告分开回答:第一张卡逐格列出实际频数 O 与期望频数 E(E = 行合计 × 列合计 / N),并给出最小期望频数与 E<5 的格子占比这两项近似条件体检;主结果表在 Pearson χ² 之外还给出似然比 G²,两者渐近等价、自由度相同,结论不一致就是样本量偏小的信号;第四张卡用 Cramér's V(附 95% 置信区间与 Bergsma 偏差校正版本,2×2 表另给 φ 与优势比 OR)回答强度,用逐格调整后标准化残差回答来源。
需要准备什么数据
- 放入分组 [定类] 变量X:定类变量(分组/标签)
- 放入 [定类] 变量Y:至少 1 个,定类变量(分组/标签)
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 30%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
- 「放入分组 [定类] 变量X」的类别数需在 2~15 之间。
- 「放入 [定类] 变量Y」的类别数需在 2~15 之间。
- 「放入分组 [定类] 变量X」的每一组至少 5 个样本。
- 「放入 [定类] 变量Y」的每一组至少 5 个样本。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 吸烟与否 × 疾病严重程度
- 用户来源渠道 × 是否付费
- 学历分组 × 满意度等级
- 问卷里两道选择题之间的交叉分析
要求每个观测只落进一个格子,且不同观测互相独立。数据规模上,行列变量各自需要 2~15 个类别、每个类别至少 5 条记录,总行数不少于 20。类别太多会把每格频数稀释掉,正确的做法是先把语义相近的低频类别在“数据标签”里归并,而不是硬跑。
什么时候不要用它
- 同一批人被测了两次(治疗前后是否达标、改版前后是否点击):这是配对的分类数据,独立性前提不成立,应改用「配对卡方检验」(McNemar)。
- 期望频数太小:2×2 表要求所有格的期望频数不低于 5;更大的表要求所有格不低于 1,且期望频数小于 5 的格子占比不超过 20%。不满足时看「Fisher精确检验」或「Yates校正卡方检验」,或者先把语义相近的低频类别合并成一类。
- 表格里填的是均值、金额或比例,而不是人数、次数:卡方检验的输入必须是计数,喂进比例会让 χ² 随你选的分母尺度任意变大变小。想比较各组的平均水平,两组用「独立样本T检验」、三组及以上用「单因素方差分析」;手上只有汇总好的百分比时,先用各组样本量把百分比还原成人数再回来做卡方;只想描述构成比、不做检验,用「列联(交叉)分析」。
- 想检验一个分类变量的分布是否符合某个理论比例(不是两个变量的关联):用「卡方拟合优度检验」。
容易误读的地方
- 卡方值的大小不能当关联强度用。 同样的百分比结构,样本量翻十倍,卡方值大致也翻十倍,p 值随之变小,但两个变量的关联一点没变强。要说“关联有多强”,只能用第四张卡的 Cramér's V(2×2 表还有 φ 与优势比),这些指标不随样本量放大。判读按 Cohen(1988) 的四档:小于 0.1 可忽略、0.1~0.3 小、0.3~0.5 中等、0.5 以上大;自由度更大时这几个阈值还要往下调。
- Cramér's V 的置信区间下限是 0.000,不等于“没有关联”。 这个区间由非中心卡方分布反解非中心参数得到(Smithson 法),它是等尾区间,所以下限刚离开 0 实际对应的是 p 小于 0.025。示例数据里 χ²(2)=6.192、p=0.045 已经显著,V=0.144 的 95%CI 照样显示成 [0.000, 0.248]。把这个 0 读成“不显著”,会和同一张报告里的 p 值直接打架。另外样本 V 本身系统性偏高,同一行的“偏差校正 V”才是小样本下更接近总体值的那一个。
- 显著只说明“不独立”,没告诉你问题出在哪一格。 一张 3×2 表显著,很可能只是其中一格严重偏离。定位差异来源要看第四张卡的逐格调整后标准化残差:正残差表示这一格的实际人数明显多于独立情况下的期望,负残差反之。常见的错误是直接指着列百分比最高的那一格说“就是它导致了关联”——百分比高低和“偏离期望”完全是两回事。
- 整体显著,却一格都没通过逐格检验,这不是矛盾。 残差表的 p 已按格子数做过 Bonferroni 校正。示例里最大的残差是 ±2.49(未校正时 |e|>1.96 就对应 p<0.05),但除以 6 个格子校正后 p=0.078,判定栏写的是“无显著偏离”。整体检验把所有格的偏离累加起来才够显著,单看任何一格都不够——此时正确的写法是报告整体关联并结合列百分比描述趋势,而不是挑一格说它显著。
- 期望频数的条件是对期望频数说的,不是对实际频数。 某一格实际只有 2 个人并不一定违规,要看那一格的期望是多少;反过来,实际人数不算少但期望很小的情况也存在。第一张卡逐格给出期望频数,直接照着核对即可。还要注意:Yates 连续性校正与 Fisher 精确检验只对 2×2 表给出,R×C 表那一列固定显示“—”,那是没有对应的经典校正式,不是算失败了。
- 关联不等于因果,也不指示方向。 “吸烟状况与疾病严重程度显著关联”在统计上只意味着这两列不独立:既不能推出吸烟导致疾病,也不能排除年龄、职业之类的第三变量同时影响了两者。Cramér's V 永远非负,方向只能从残差的正负号与列百分比里读。
同一个差异,只把样本量从 20 加到 2000:效应量 Cohen's d 始终是 0.30,p 却从 0.35 掉到小于 0.001。p 变小说明「证据变足」,不说明「差异变大」——差多少要看效应量与它的置信区间。
看到 r = 0.62,X 导致 Y、Y 导致 X、第三个变量同时影响两者、纯属巧合这四种情况都可能,相关系数本身分不清它们。能分清的是研究设计——随机化、工具变量、断点,而不是往模型里多塞几个控制变量。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:卡方检验交叉表与主结果
- 输出结果三:交叉分析可视化
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
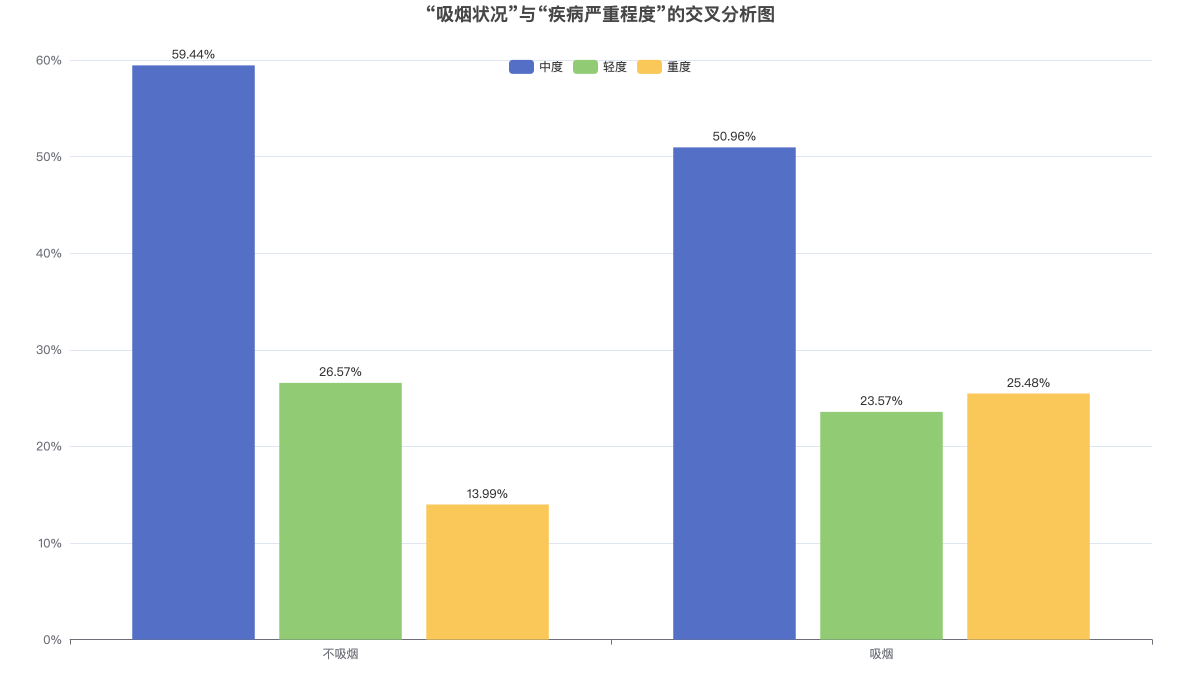
上图将“吸烟状况”与“疾病严重程度”的列百分比进行了可视化,可通过上方控件切换不同的图表类型(如柱形图、堆积图等)进行观察。亦可通过图上方的视图切换器切到「表格」查看同一份列百分比数据。
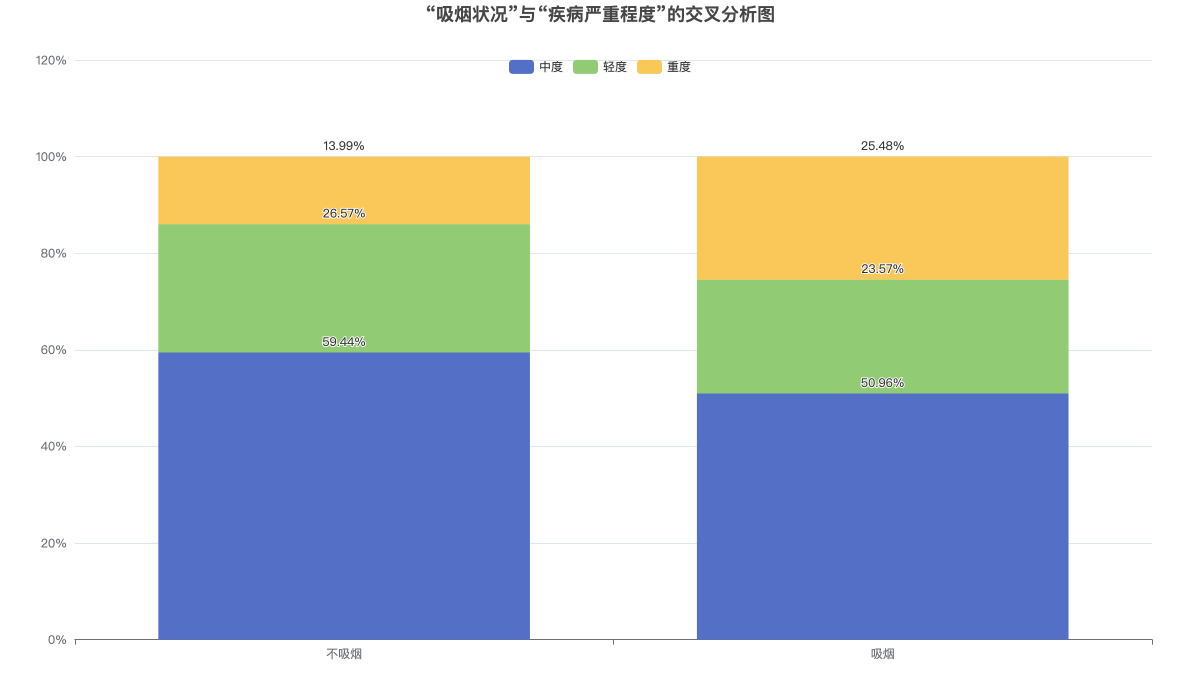
上图将“吸烟状况”与“疾病严重程度”的列百分比进行了可视化,可通过上方控件切换不同的图表类型(如柱形图、堆积图等)进行观察。亦可通过图上方的视图切换器切到「表格」查看同一份列百分比数据。
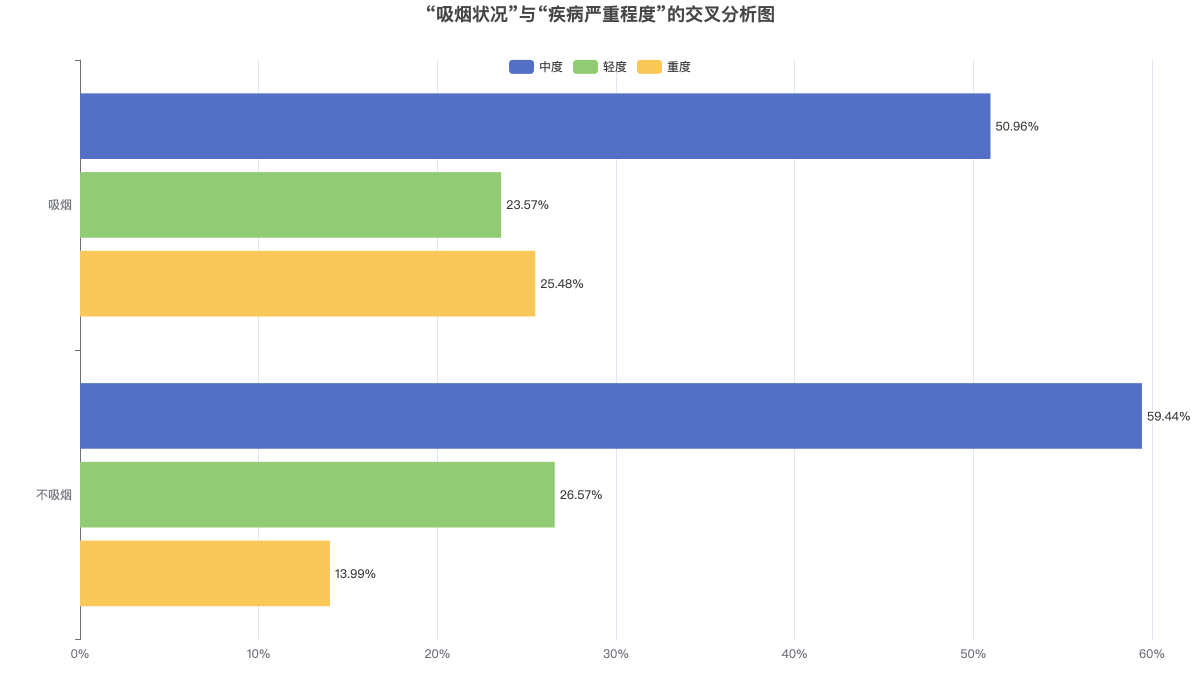
上图将“吸烟状况”与“疾病严重程度”的列百分比进行了可视化,可通过上方控件切换不同的图表类型(如柱形图、堆积图等)进行观察。亦可通过图上方的视图切换器切到「表格」查看同一份列百分比数据。
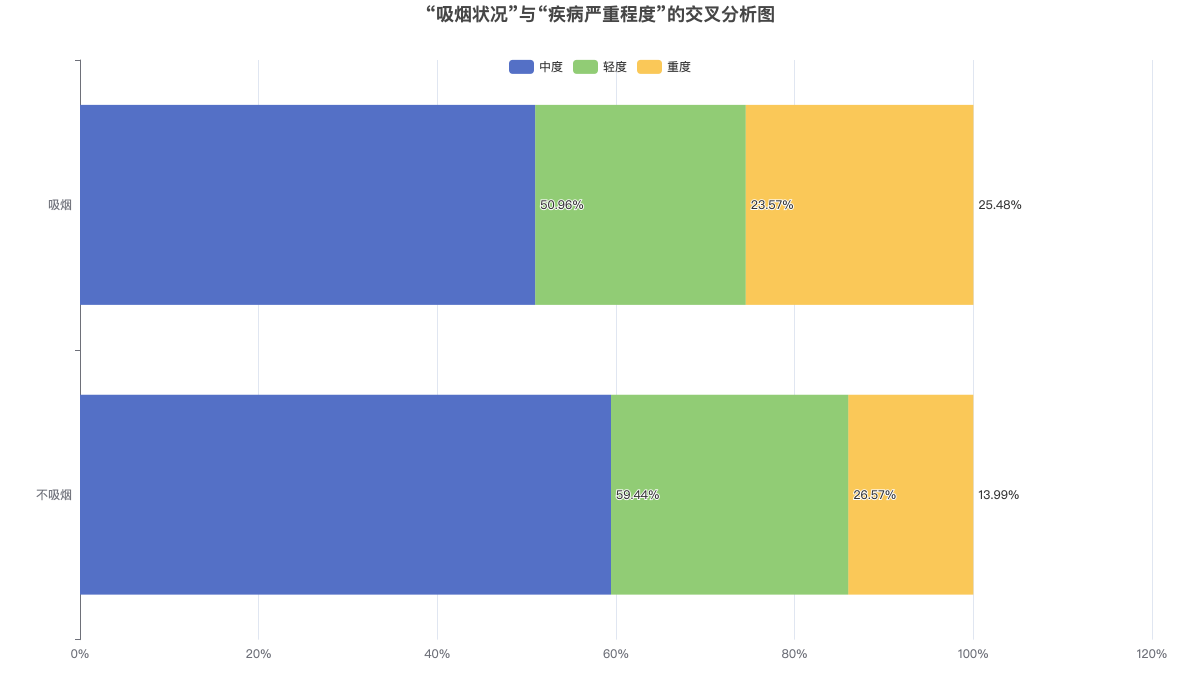
上图将“吸烟状况”与“疾病严重程度”的列百分比进行了可视化,可通过上方控件切换不同的图表类型(如柱形图、堆积图等)进行观察。亦可通过图上方的视图切换器切到「表格」查看同一份列百分比数据。