
因子分析(探索性)
这个方法是做什么的
一批彼此相关的数值变量(最典型的是问卷题项),背后可能只由少数几个看不见的“因子”驱动。这个方法把这些变量压缩成几个因子,告诉你每个变量主要归属哪个因子(载荷矩阵)、每个因子解释了多少信息(方差解释表分“初始特征根 / 提取平方和载荷 / 旋转平方和载荷”三组列,旋转只重新分配各因子的份额,不改变累计解释率)。
本模块用主成分法提取因子,因子个数在顶部指定:既可以直接填“主成分个数为”几个,也可以改成“特征根阈值为”让它按 Kaiser 准则自动决定;旋转方式默认最大方差法(varimax),另有 Promax、直接 Oblimin 等五种可选。它还给出因子得分系数矩阵(系数 = 相关矩阵的逆 × 载荷矩阵,得分由标准化后的变量加权求和),并按各因子方差贡献率占比加权,给每个样本算综合得分与排名。
需要准备什么数据
- 放入 [定量] 变量:至少 2 个,定量变量(数值)
- 放入 [定类] 摘要 (可选)(可选):定类变量(分组/标签)
数据要求
- 数据表至少 5 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 问卷有几十道题,想看它们实际聚成了几个维度
- 想把一堆高度相关的指标降成少数几个综合指标,再拿去做回归或评价
- 需要一套可复现、可写进论文的综合评价得分与排名
第一张卡先做适用性体检:总体 KMO(大于 0.6 可接受、0.7 良好、0.8 很好)与各变量的单项 MSA(低于 0.5 建议剔除)、Bartlett 球形检验、相关矩阵行列式(越接近 0 越接近奇异、得分系数越不稳),以及样本量与变量数之比。
什么时候不要用它
- 你已经有一个明确的理论结构,想验证它对不对:那是验证性因子分析(CFA)的任务,本产品未提供 CFA 模块,不要拿探索性因子分析冒充——它总能给你一个结构,哪怕数据是随机的。产品内可行的替代路径是:把每个理论维度分别放进「信度分析」看内部一致性,用「效度分析」核对题项是否按理论归位,再把本模块的载荷矩阵与预设维度逐题对照。这只能说明“数据与理论不矛盾”,不等于统计意义上的验证,论文里要如实写。
- 变量之间本来就几乎不相关:第一张卡的 Bartlett 球形检验不显著,就意味着提取公共因子这件事本身没有意义;KMO 太低、单项 MSA 低于 0.5 同理。先按提示剔掉低 MSA 的变量再试一次;若仍不显著,说明这批指标没有共同信息可提——只想压缩维度就用「主成分分析(PCA)」(纯数学降维,不假定背后存在公共因子),要做综合评价与排名则改用不依赖相关结构的客观赋权法,如「熵值法」或「变异系数法」。
- 样本量太小:下方“数据要求”里的行数下限是技术下限,不是统计下限(只要求有效样本数大于变量个数,否则相关矩阵奇异)。探索性因子分析常用的经验要求是样本量不低于变量数的 5~10 倍且总量不少于 100,第一张卡会给出实测比值。样本不够时载荷抖动极大,换批数据结构就变。出路有三条:先用「信度分析」的校正题总相关剔掉冗余题,抬高样本量与变量数之比;或改用对样本量要求更低的「主成分分析(PCA)」;或者综合评价改走「熵值法」这类不估计公共因子的赋权路线,等样本补足再回来。
- 只想降维、不关心因子的可解释性:用「主成分分析(PCA)」更直接。
容易误读的地方
- 因子叫什么名字是你定的,不是数据算出来的。 报告只给出“哪些变量在哪个因子上载荷高”,命名成“服务质量”还是“一线体验”完全是研究者的解释。第四张卡的简单结构诊断能判断这一步靠不靠谱:它按 |载荷| ≥ 0.4 找出各变量的主载荷,只有“每个变量只在一个因子上高载荷、每个因子至少由 3 个变量定义”(Thurstone 简单结构)时命名才有依据。有交叉载荷还照样命名,是把主观解释写成了结论。
- 换一种旋转方式,载荷就换一批,而它们在数学上同样成立。 因子解存在旋转不定性:varimax、promax、oblimin 会给出不同的载荷模式,没有哪一个是“真的”。因此旋转方式必须在论文里写明,也不能反复换旋转直到出现自己想要的那个结构;载荷矩阵还要完整报告,只挑高载荷贴出来会把交叉载荷问题藏起来。
- 特征根大于 1 不是可靠的因子数判据。 Kaiser 准则在变量较多时系统性高估因子个数。第四张卡的 Horn 平行分析才是客观依据:它按同样的行数与列数生成随机数据、重复 500 次、取各位次特征根的 95 百分位当参考线,实际特征根高过它的因子才算携带了超出噪声的信息(种子固定,可复现;碎石图上的橙色虚线就是这条线)。两者不一致时以平行分析为准,回顶部把因子个数改成它建议的数目重跑。
- 累计方差解释率不是“模型有多准”。 它只是说前几个因子重构了原始变量多大比例的方差,既没有做假设检验,也不保证这个结构换一批样本还成立。除了 Bartlett 球形检验,本模块不产生 p 值和置信区间——第四张卡的平行分析、共同度、简单结构诊断是信息保留与结构清晰度的度量,不是显著性检验。共同度按经验判读:0.60 以上充分、0.40~0.60 一般、低于 0.40 说明该变量信息大量流失,该考虑拿掉。
- 综合得分的权重来自数据,不来自业务重要性。 得分按各因子解释的方差比例加权(报告会把“39.76% × F1 + 34.66% × F2 + …”这个公式原样打出来),隐含的假定是“解释方差越多的因子越重要”。做“哪个门店综合表现最好”这类排名时,这个假定未必成立:方差很小、但业务上决定生死的维度会被自动压成很低的权重。拿它去做决策必须把这条假定明说出来。综合得分还是标准化尺度上的相对值,均值约为 0,正值只表示优于本批样本平均,换一批样本不能直接比。
- 换个因子数,排名可能就变了。 第四张卡把因子数 ±1 各重新拟合一次、重算得分,再用 Spearman 秩相关报告排名一致性。ρ 接近 1 说明结论稳健,可写进论文的稳健性段落;ρ 明显偏低说明排名其实是“选了几个因子”选出来的,此时不能只报当前设定这一版。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:方差解释、载荷与综合得分主结果表
- 输出结果三:可视化(碎石图与因子载荷图)
- 输出结果四:因子保留判据、结构清晰度与信息保留诊断
- 输出结果五:结论与学术表述
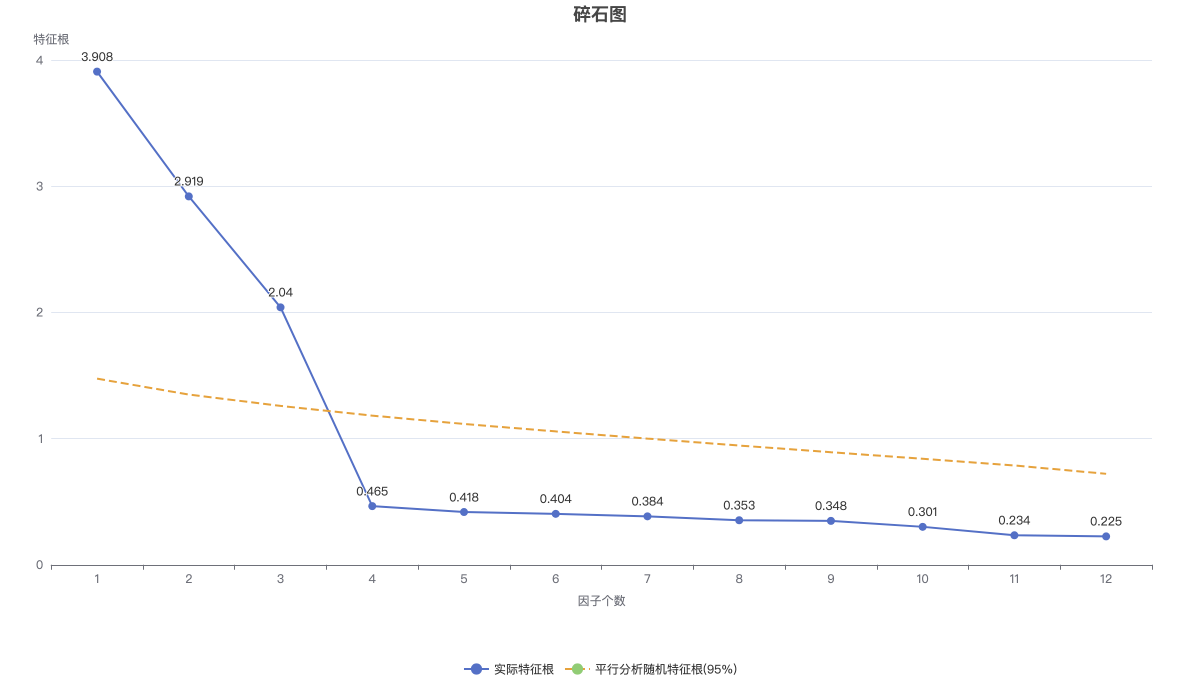
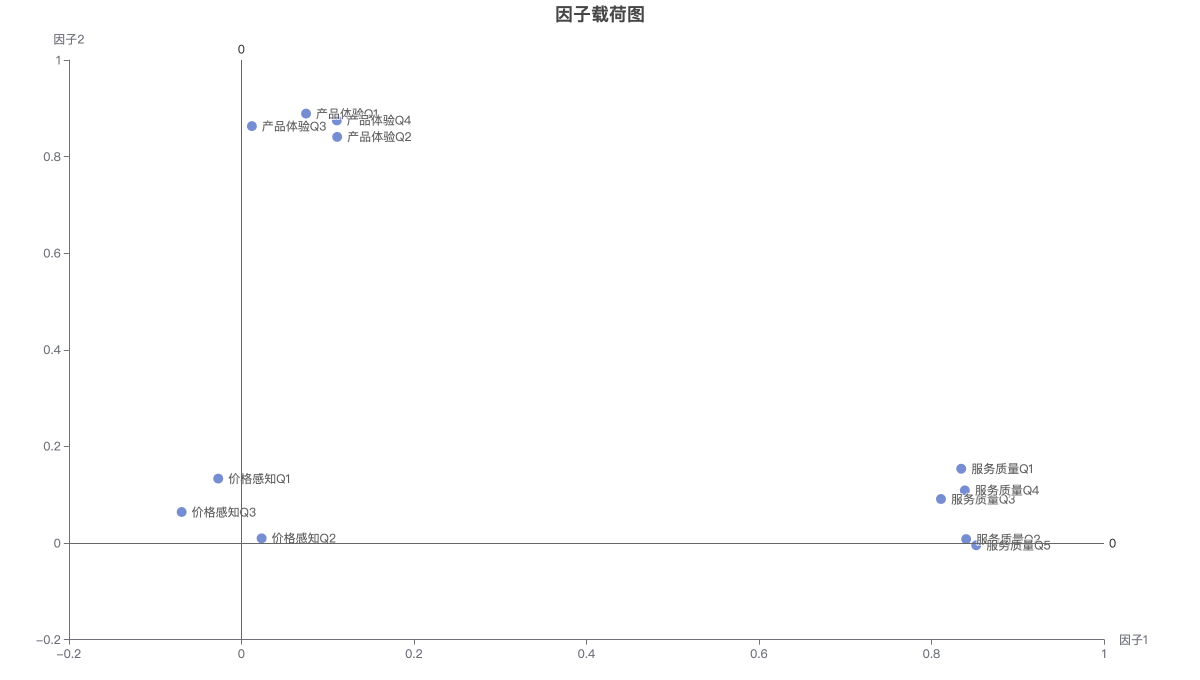
上图为碎石图,可切换为柱形图/表格视图,橙色虚线为平行分析在同规模随机数据上得到的特征根 95 百分位参考线 —— 实际特征根高于该线的因子才被认为携带了超出随机噪声的信息;下图为因子载荷图(前两个因子构成的平面),点离原点越远说明该变量被因子解释得越充分。