
Pearson相关性分析
这个方法是做什么的
衡量两个数值变量之间线性关系的强弱与方向,结果就是相关系数 r:+1 是完全正向的直线关系,−1 是完全反向,0 是没有线性关系。r 与量纲无关,所以“元”和“分钟”之间也能比。显著性由 t = r·√(df/(1−r²)) 给出(df = 有效样本量 − 2),95% 置信区间用 Fisher z 变换求出后截断到 [−1, 1]。
一次拖入多个变量时,它会把所有两两组合都算一遍(k 个变量就是 C(k,2) 对),给出逐对的三线表、系数与 p 值并排的相关矩阵、热力图,以及相关最强那一对的散点图(附最小二乘拟合线的斜率与截距)。第四张卡再补上 r²、Cohen 效应量分级与 Holm-Bonferroni 校正后的判定。缺失按成对删除处理:每一对只剔除这两列上缺失的行,所以各对的有效 N 可能不一样。
需要准备什么数据
- 放入[定量]分析变量:至少 2 个,定量变量(数值)
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 想快速看清一批指标彼此之间怎么共变(问卷各维度得分、门店各项经营指标)
- 建回归模型之前先摸底自变量之间是不是高度相关
- 需要一个标准化、可跨研究比较的关联强度
至少要拖 2 个定量变量,总行数不少于 30,且不能是常数列(方差为 0 时相关系数无定义)。
什么时候不要用它
- 两个变量的关系明显不是直线(U 形、指数、有天花板效应):r 会严重低估这种关系。先看散点图,或改用能捕捉任意单调关系的「Spearman相关分析」。
- 变量是等级或序数(满意度 1~5 星、名次):用「Spearman相关分析」或「Kendall’s tau-b相关分析」。
- 有明显的极端值:Pearson 对极端点极其敏感,几个点就能把 r 从 0.1 拉到 0.6。第一张卡的留一法诊断就是查这个的——逐个剔除单个观测后 r 的最大变动 max|Δr| 达到 0.10 就算强影响点。确认这些点不是录入错误又不能删时,改用只按名次计算、对极端值稳健的「Spearman相关分析」。
- 你真正想问的是“控制住某个变量之后还剩多少关联”:用「偏相关分析」。
- 你想知道的是“X 能不能预测 Y、影响有多大”,而不是“两者共变”:用「线性回归 (最小二乘法)」,它能给出有单位的斜率、置信区间与整套模型诊断,相关系数给不了这些。
容易误读的地方
- 相关不等于因果——这条比它听起来更容易违反。 r 显著只说明两个变量一起变;谁先谁后、谁影响谁,数据里没有这个信息。更常见的情况是第三个变量同时推动了两者(“冰淇淋销量”和“溺水人数”都由气温驱动)。如果你已经能说出可能的混杂变量,请改用偏相关把它控制住再看。
- r 接近 0 只能排除线性关系,不能排除关系。 一个漂亮的倒 U 形(投入太少和投入太多效果都差)算出来的 r 可能就是 0.02。画散点图是必须的一步,不能只看系数表。模块也给了一个不用画图就能看的信号:第一张卡把每一对的 Pearson r 与 Spearman ρ 并排放着并算出 |r−ρ|,两者差得明显(经验上 0.10 以上)就提示这一对可能是曲线关系,该去看散点图了。
- 正态性被拒绝,不等于这个 r 不能用。 第一张卡对每个变量跑 Shapiro-Wilk,很多人看到某一列“拒绝正态”就以为整个分析作废。r 本身只是两列数据的标准化协方差,算它不需要任何分布假设;正态性影响的只是它的 t 检验与 Fisher z 置信区间准不准。所以正确的反应是:样本量够大时照常报告,结论卡在显著性临界值附近时再用「Spearman相关分析」复核一遍,两边一致就更稳妥。
- 一次拖 5 个变量,就是同时做了 10 次检验。 每次检验各有约 5% 的假阳性概率,10 次下来“至少中一次”的概率远高于 5%。第四张卡给出 Holm 校正后的 p 与判定,以校正后的为准,而不是主结果表里未校正的那一列——两者结论不一致是很常见的,实测中就出现过未校正 8 对显著、校正后只剩 7 对的情况,掉队的那一对恰好是 r 最小的。
- 相关矩阵里各格的样本不一定是同一批人。 成对删除意味着“A 与 B”这一格用的是 A、B 都不缺失的行,“A 与 C”那一格用的是另一批行。数据缺失较多时,同一张矩阵里的系数其实来自不同的子样本,既不能把它当成一套内部一致的结构去解读,也不适合直接搬去做后续的因子分析或回归。主结果表逐行给出了每一对的 N,先扫一眼这一列差得多不多。
- 显著的相关不一定是有用的相关。 样本量到 1000 时,r = 0.07 就能做到 p 小于 0.05,但它对应的 r² 只有 0.005,两个变量几乎没有共同变化。判断有没有实际价值要看 r 与 r² 的大小——第四张卡按 Cohen(1988) 直接分好了级:|r| 大于等于 0.5 大、0.3~0.5 中、0.1~0.3 小、低于 0.1 微弱。r² 是两列数字重叠的方差比例,也别把它读成“一个变量决定了另一个的百分之多少”这种因果语气。
同一个差异,只把样本量从 20 加到 2000:效应量 Cohen's d 始终是 0.30,p 却从 0.35 掉到小于 0.001。p 变小说明「证据变足」,不说明「差异变大」——差多少要看效应量与它的置信区间。
看到 r = 0.62,X 导致 Y、Y 导致 X、第三个变量同时影响两者、纯属巧合这四种情况都可能,相关系数本身分不清它们。能分清的是研究设计——随机化、工具变量、断点,而不是往模型里多塞几个控制变量。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:Pearson 相关分析主结果表
- 输出结果三:可视化
- 输出结果四:效应量与多重比较校正
- 输出结果五:结论与学术表述
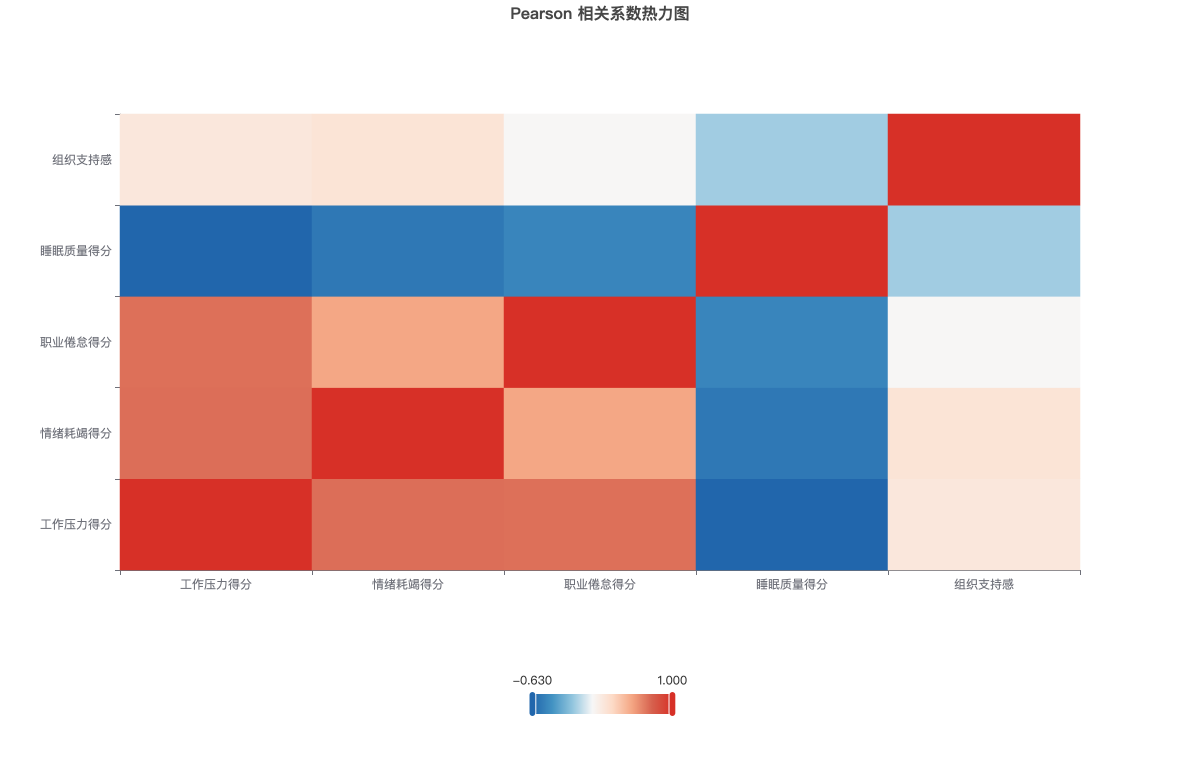
热力图以颜色映射相关系数;配色按系数取值的正负分布自动在顺序型/发散型之间切换。右上角切换器可将同一份数据改看柱状图/条形图或明细表(契约 §3)。
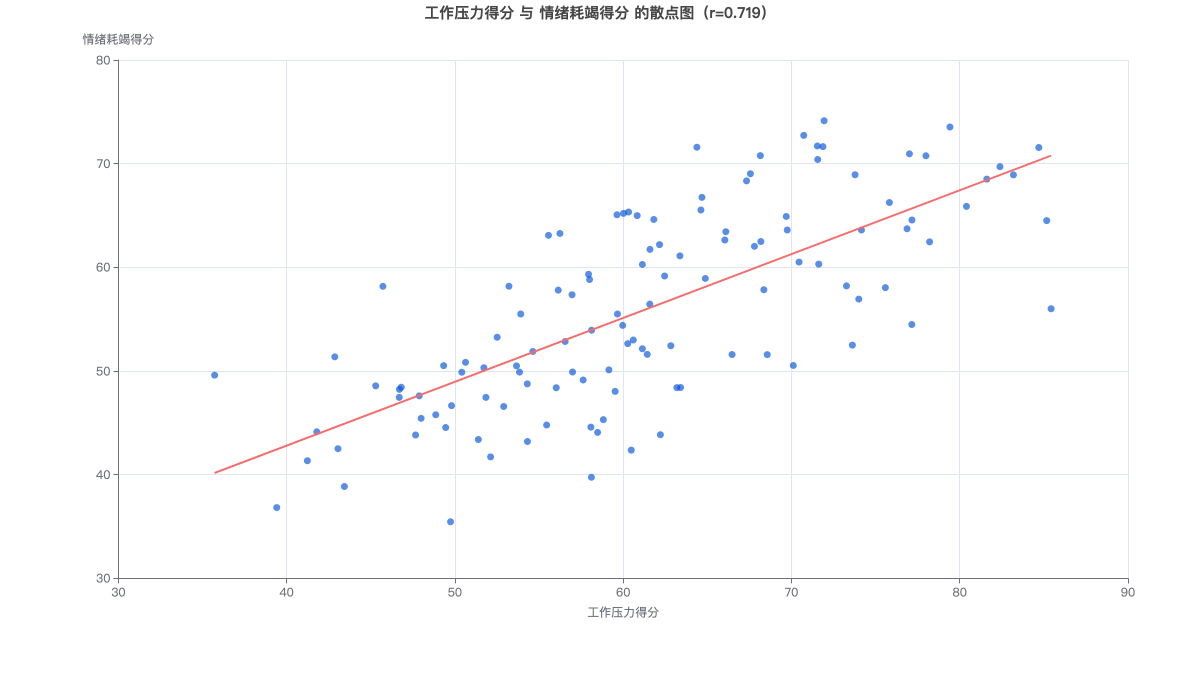
上图为相关最强的一对变量「工作压力得分 — 情绪耗竭得分」的散点图,红线为最小二乘拟合线(斜率 0.6157,截距 18.1748)。