
正态性分析
这个方法是做什么的
检验一个或多个数值变量是否服从正态分布。它的原假设是“服从正态”,所以 p 小于 0.05 表示拒绝正态,p 大于等于 0.05 表示没有足够证据拒绝——这两句话的差别很关键,见下方“容易误读的地方”。
报告一共给五种检验:主判据 Shapiro-Wilk(适用 3~5000 个有效观测,这个区间内功效最高),加上 Lilliefors 修正的 K-S、Jarque-Bera,再补 D'Agostino-Pearson K²(要求 n≥8)与对尾部更敏感的 Anderson-Darling。除此之外还有不随样本量变化的形态指标——偏度与超额峰度及各自的标准误、95% 置信区间与 z 值,以及直方图、P-P 图与 Q-Q 图。第一张卡另有一张“适用前提”表,把原假设、观测独立性、样本量与功效、并列值、离群点、多重比较六件事逐行摆出来,凡是数据判不了的就写“无法验证”,不下结论。
需要准备什么数据
- 数值变量(≥1个):至少 1 个,定量变量(数值)
数据要求
- 数据表至少 3 行。
- 单列缺失率不超过 50%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 决定某个指标该报“均值±标准差”还是“中位数(四分位距)”
- 做参数方法之前先了解数据的分布形态
- 论文的方法部分需要交代正态性是怎么判定的
什么时候不要用它
- 你要检验的其实是回归残差:残差的正态性已经由「线性回归 (最小二乘法)」的第一张卡直接给出(用的就是本模块同款的 Shapiro-Wilk 与 Jarque-Bera),不需要把原始变量单独拿来跑——原始变量正态与否,本来就不是回归的前提。
- 变量是分类或等级:正态性对它们没有意义。要看分布就用「频数分析」,要看两个分类变量的交叉构成就用「列联(交叉)分析」;后续要做组间比较,直接选本来就不要求正态的方法,如「独立样本 Mann-Whitney U 检验」或「多独立样本Kruskal-Wallis检验」。
- 样本量非常小:检验几乎检不出任何偏离,“不拒绝正态”是必然结果,跑它得不到信息。这时应当跳过这一步,直接用「描述性统计」看偏度、峰度与箱线图判断形态,方法上则选不依赖正态假设的「独立样本 Mann-Whitney U 检验」「配对样本Wilcoxon检验」「多独立样本Kruskal-Wallis检验」。
- 你已经确认偏离正态、想把它掰回来:本模块只诊断不处理,用「数据变换(Box-Cox/Yeo-Johnson)」做变换后再回来复检。
容易误读的地方
- “p 大于等于 0.05”不能写成“数据服从正态分布”。 所有正态性检验都只能拒绝正态,不能证明正态。p 大只意味着“现有数据不足以否定它”——样本量小的时候,这句话几乎总是成立。规范的表述是“未拒绝正态假设”。
- 结论几乎由样本量决定。 同一份只是轻微右偏的数据,n = 30 时不显著、n = 3000 时必然显著。所以大样本下的“拒绝正态”往往没有实际意义:真正该看的是偏度和峰度这两个不随样本量变化的量,它们在第四张卡上带着标准误与 95% 置信区间。报告的偏离分级也是照它们分的:|偏度|<0.5 且 |超额峰度|<1 算接近正态,再往上依次是轻度、中度、严重。不少方法学文献认为偏度绝对值小于 2、超额峰度绝对值小于 7 时,参数方法仍然相当稳健。
- 别用它来决定“能不能用 t 检验 / 方差分析 / 回归”。 这些方法要求的从来不是原始变量正态,而是残差近似正态,或者样本量足够大(中心极限定理)。“先跑正态性检验,不过就改非参数”这个流程本身是反的:它在小样本时因为检不出而放行,在大样本时因为几乎必然显著,把本来完全稳健的情形赶去用效能更低的非参数方法——两头都错。
- 五个检验摆在一起,不是让你挑一个顺眼的报。 报告已经写死了优先级:以 Shapiro-Wilk 为主判定,它不适用时才退到 K-S(Lilliefors),再退到 Jarque-Bera;三者结论不一致时优先看 S-W,同时把这件事本身当作“偏离处在临界区”的信号写进结论,而不是找一个 p 最大的贴上去。补充的两个也各有边界:D'Agostino-Pearson K² 只由偏度 z 与峰度 z 平方相加而来,n 小于 8 就不适用;Anderson-Darling 在报告里只给 A² 与 5% 临界值、没有 p 值,那不是漏算,是 scipy 本来就不提供,只能按“超没超过临界值”判读。同理,第四张卡的 Holm 校正只会把 p 推大、更难拒绝正态,它防的是“误判为不正态”——绝不能反过来读成“校正后不显著,所以证明了正态”,那和上面第一条直接冲突。
- 唯一取值数远小于样本量时,检验会系统性偏向拒绝正态。 李克特量表这类数据只有 5 个可能取值,几百个观测挤在这 5 个点上,产生大量并列值,S-W 与 K-S 都会因此报显著——这反映的是“数据本来就是离散的”,不是分布形状有问题。第一张卡专门给出了每个变量的唯一取值数,就是让你先看这一列:它明显小于样本量时,正态性检验的 p 值不必再解释,改看直方图与偏度峰度。同样地,几个录入错误造成的极端值也足以让检验拒绝正态,报告的离群点计数(Tukey 1.5×IQR)就在旁边,该先去核对数据而不是急着换方法。
- 三张图看的不是同一件事。 直方图叠了理论正态曲线,看的是整体形状;P-P 图比的是累积概率,对分布中部敏感,呈 S 形通常意味着偏度或峰度异常;Q-Q 图比的是分位数,对尾部敏感,两端翘起或下垂说明尾巴比正态更重或更轻。图形与检验结论不一致时的处理方向也是明确的:小样本以图形为主(检验功效不足),大样本以效应量为主(检验对微小偏离过度敏感)。
同一个差异,只把样本量从 20 加到 2000:效应量 Cohen's d 始终是 0.30,p 却从 0.35 掉到小于 0.001。p 变小说明「证据变足」,不说明「差异变大」——差多少要看效应量与它的置信区间。
检验只能拒绝原假设,不能证明它成立。p = 0.42 既可能是真的没有差别,也可能是样本量不够、差别没被检出来,两者从这个 p 值上分不开。规范的写法是「没有证据表明……」;要论证「两者确实相当」,需要另做等价性检验。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:主结果表(正态性检验)
- 输出结果三:可视化(直方图 / P-P图 / Q-Q图)
- 输出结果四:效应量与事后分析
- 输出结果五:结论与解读
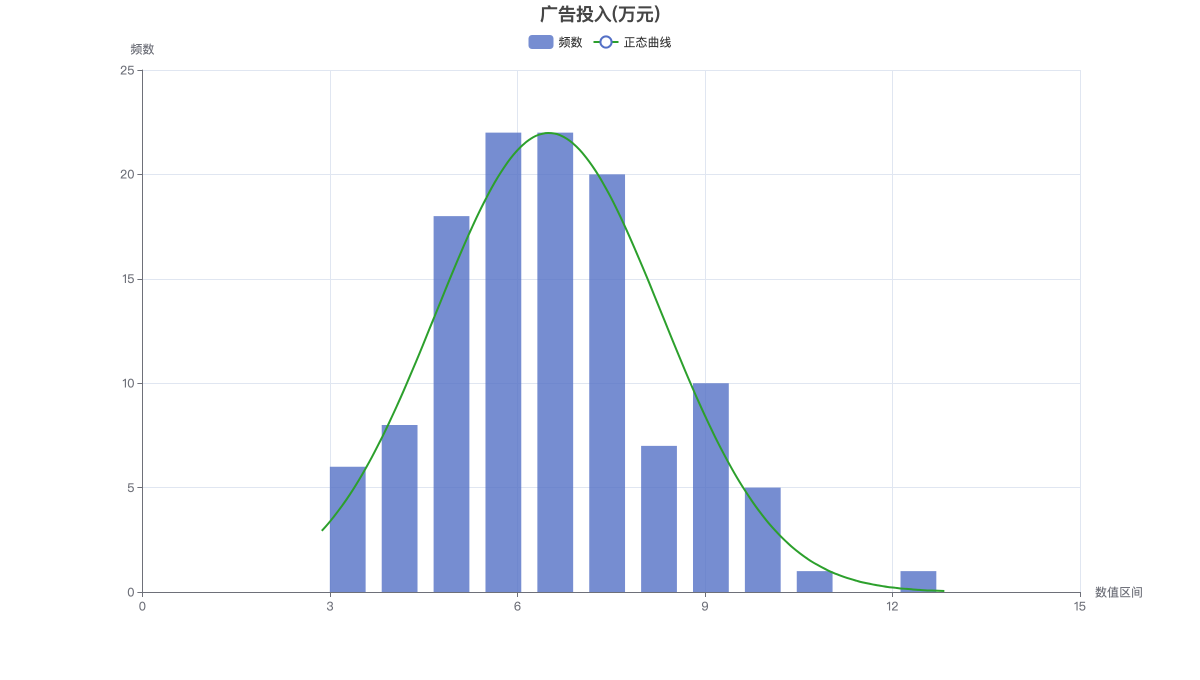
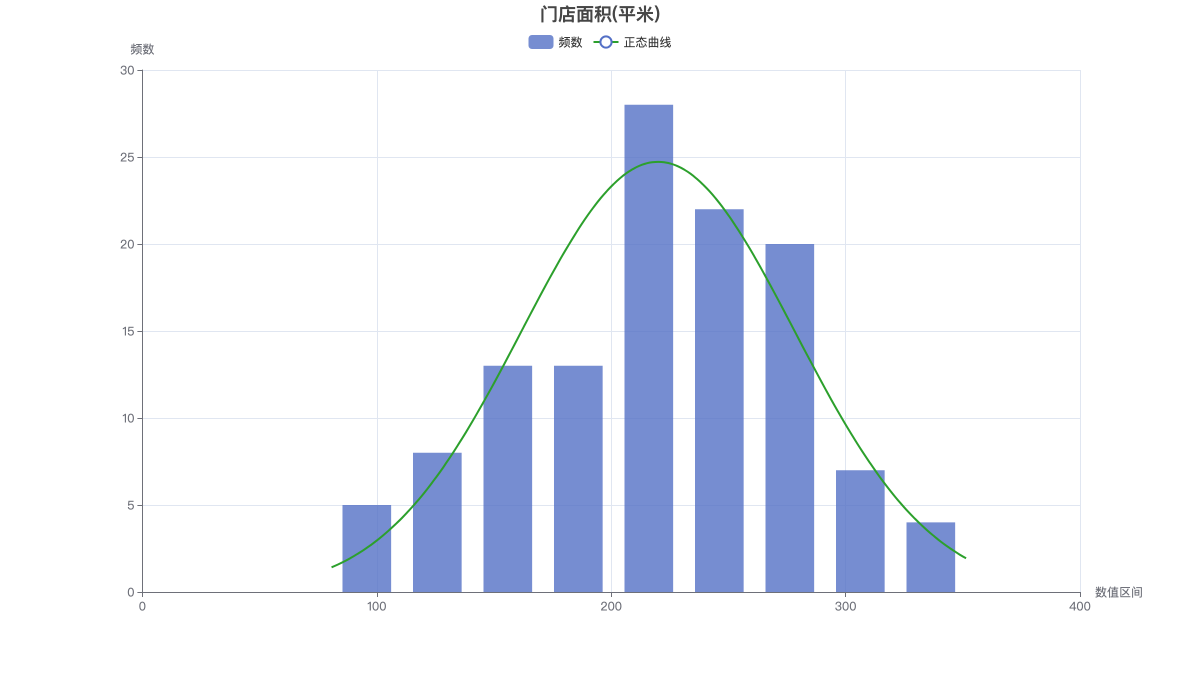
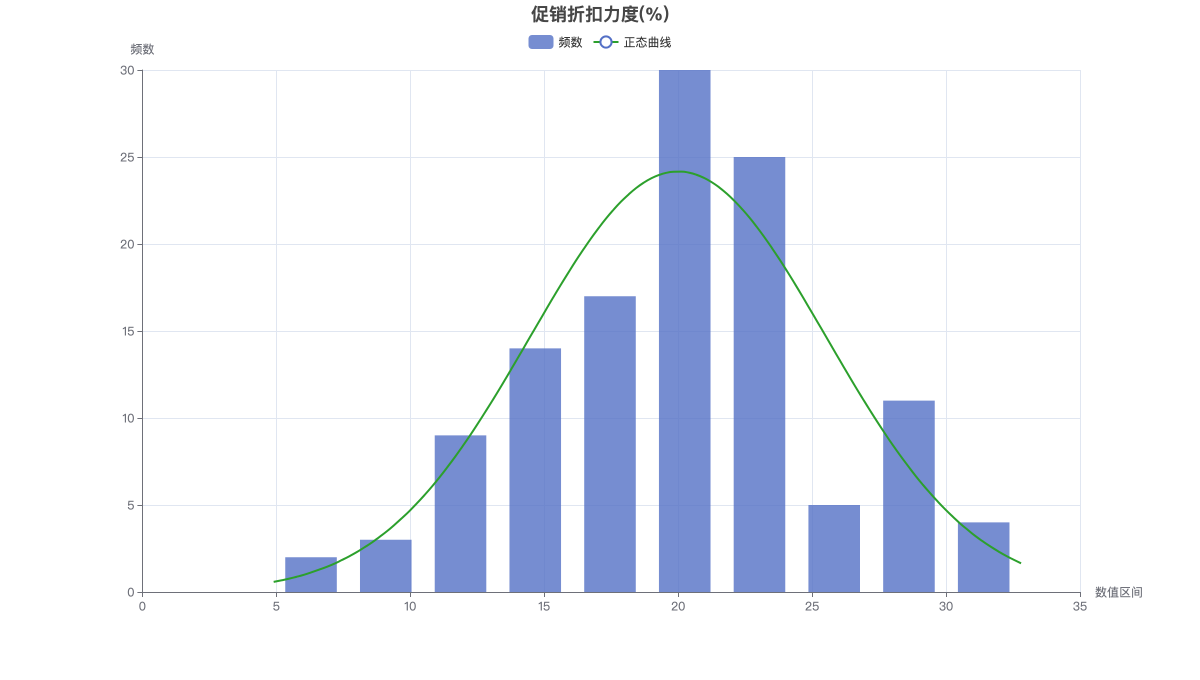
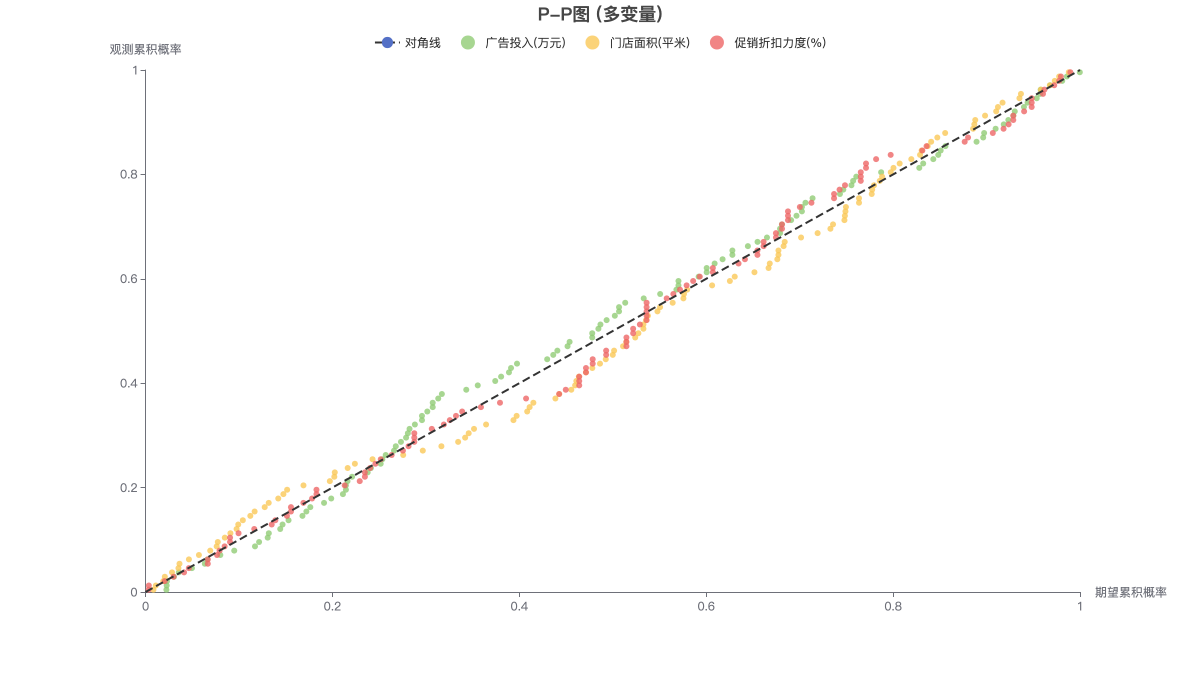
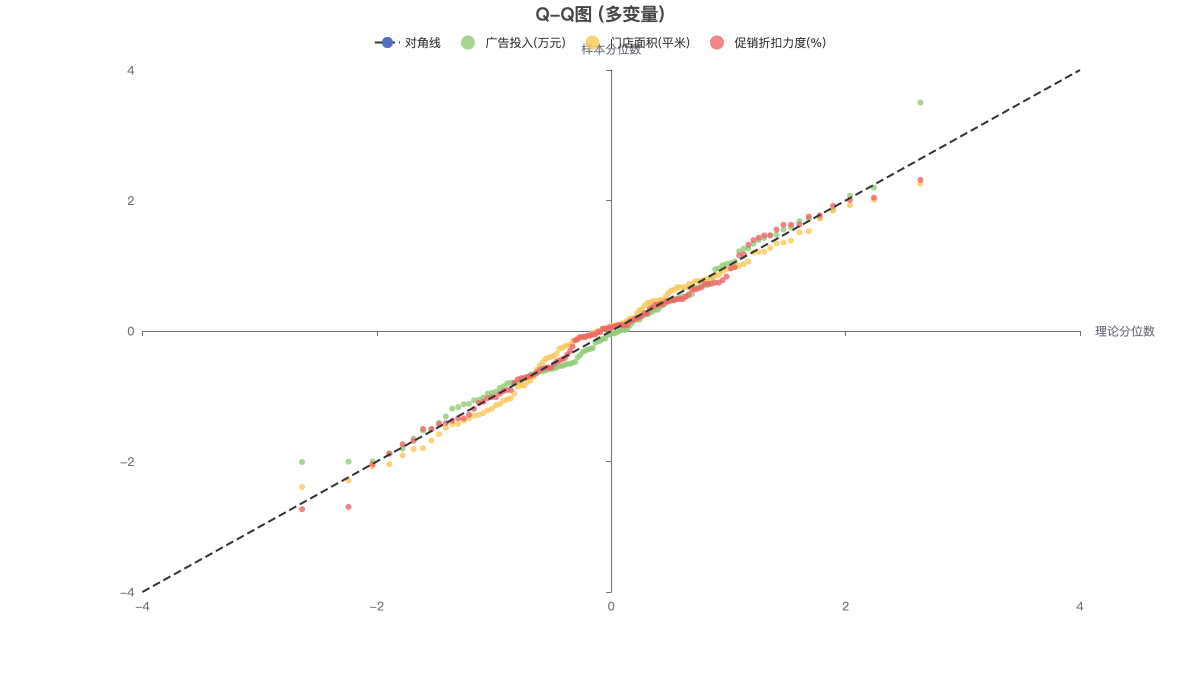
直方图叠加理论正态曲线用于看整体形状;P-P 图对分布中部敏感;Q-Q 图对尾部敏感。无变异或样本量不足的变量不会出现在图中。