
逻辑回归
这个方法是做什么的
因变量是“发生 / 不发生”这类两分类结果时用的回归方法。它不直接预测 0 或 1,而是预测事件发生的概率,并把每个自变量的影响表达成优势比 OR:OR 大于 1 是危险因素,小于 1 是保护因素,等于 1 表示没有关联;OR 的 95% 置信区间不含 1 与 p 小于 0.05 完全等价,而区间宽度还告诉你这个估计有多准。
报告除了 B、Wald χ²(= (B/标准误)²,每行自由度都是 1)与 OR,还给出模型整体的似然比检验、AIC/BIC、三种伪 R²、Hosmer-Lemeshow 校准检验、ROC 曲线与 AUC、混淆矩阵和一整套分类指标。自变量可以是数值也可以是分类,分类的会自动做哑变量编码;另有一个可选的权重区,放进去的列必须是非负数值。
需要准备什么数据
- 放入[定类]因变量Y:1 个,定类变量(分组/标签)
- 放入[定量]或[定类]自变量X:至少 1 个
- 放入[定量]权重项W (可选)(可选):定量变量(数值)
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 30%。
- 「放入[定类]因变量Y」必须正好是 2 个类别。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 患者术后是否复发,与年龄、肿瘤直径、术前指标的关系
- 用户是否付费,与访问次数、来源渠道、注册时长的关系
- 设备是否在保修期内发生故障
第一张卡会逐条核对前提:因变量恰好两类、事件与非事件各占多少(附 Wilson 置信区间)、EPV、事件率是否落在 15%~85% 的均衡区间、最大 VIF、有没有完全分离,以及 Box-Tidwell 检验。
什么时候不要用它
- 因变量多于两类:本模块会直接拒绝。类别有序(轻 / 中 / 重)时用「有序逻辑回归」;类别无序(三个品牌任选其一)需要多项 Logistic,本产品未提供,可行的做法是按研究问题把结局合并成两类后回到本模块,或改用能直接处理多分类的「CHAID决策树」「随机森林分类」。
- 因变量本身是数值(评分、金额):不要为了用这个方法而人为二分化,那会丢掉大量信息,且结论随切点变化;用「线性回归 (最小二乘法)」。
- 事件数太少:经验准则是每个自变量至少要有 10 个少数类事件(EPV,Peduzzi 等 1996)。300 个样本里只有 12 例复发却放了 5 个自变量,系数会被系统性高估,第一张卡直接给出 EPV 的实测值。文献推荐的 Firth 惩罚似然本产品未提供,所以出路是把自变量压到“事件数 ÷ 10”以内:用「特征筛选」挑,或按专业知识只保留核心变量,也可以把细分的类别自变量合并以减少哑变量个数;实在压不下去就别做多因素模型,退回逐个变量与结局的二元关联,用「卡方检验」或「Fisher精确检验」描述。
- 某个自变量能完美区分结局(完全分离):极大似然估计不存在,系数与置信区间会变成天文数字,第一张卡会核查这一条。标准解法 Firth 惩罚似然本产品未提供,产品内可行的路径有三条:把这个自变量的类别合并(例如把“从不 / 偶尔 / 经常”并成两档),让每一格里事件与非事件都有人;或把它从模型里拿掉、单独用「Fisher精确检验」报告它与结局的关联;或者改研究设计、扩大样本量后重跑。
容易误读的地方
- 先确认系统把哪一类当成了“事件”。 因变量是文字类别时,模块按类别名称的字符编码顺序自动指定:排在前面的编成 0(参照/非事件),后面的编成 1(事件)。举例来说,取值是“复发 / 未复发”时,“复发”会被编成 0、“未复发”编成 1——于是整份报告算的是不复发的优势比,所有 OR 都成了你想要的那个方向的倒数,真正的危险因素会显示成“保护因素”。第一张卡有一行写明了实际编码,每次都要先看这一行。 方向不对时,在顶部的“事件类别”里填上你关心的那一类(例如填“复发”),本模块就按它编码;填错会直接报错并列出实际有哪几类,不会悄悄按别的方向算。
- OR 不是风险倍数。 OR 是“优势”之比,优势 = 发生概率 ÷ 不发生概率,它和“概率之比”不是一回事。事件很罕见时两者接近,但事件率一高,OR 就会明显夸大相对风险。把 OR = 2 写成“风险翻倍”是最常见的误报之一;准确的说法是“优势为对照组的 2 倍”。
- 连续变量的 OR 是“每增加 1 个原始单位”的优势比,换个单位数字就变。 年龄以“岁”计时 OR = 0.912,改成以“天”计,同一个效应会变成一个几乎等于 1 的数,看上去像“没有影响”。所以单位很小的变量(天、元、毫升)要先换算成有意义的刻度或做标准化,并在论文里写明 OR 对应每增加多少。分类变量的 OR 则是相对参照组而言的,报告时必须点明参照组是哪一类。
- 它不要求自变量正态,但要求连续自变量与 logit(p) 成线性——这是最常被忽视的一条前提。 第一张卡的 Box-Tidwell 检验就是查它的:在模型里额外加一个 x·ln(x) 项,看这个项的系数显不显著,显著就说明关系不是线性的,此时该给这个变量分段或加平方项。两个细节:该检验要求 x 大于 0,含 0 或负值的变量会如实标成“未做”,而“未做”不代表前提成立;多个连续变量同时检验没做多重比较校正,单个 p 会略偏向“发现非线性”。
- 伪 R² 不能按线性回归 R² 的直觉去读。 McFadden、Cox & Snell、Nagelkerke 三个数衡量的是似然改善程度的不同标定,都不表示“解释了多少方差”。McFadden 达到 0.2~0.4 就已经属于很好的拟合,拿线性回归里“0.19 太低”的标准去衡量会得出完全错误的结论。Cox & Snell 的上界本身小于 1(报告会把上界打出来),Nagelkerke 就是把它除以上界重标定到 0~1 的版本;惯例是两个一起报并写明口径。Hosmer-Lemeshow 检验的方向也是反的:那里 p 大才是好事,不显著说明没检出校准偏差;但它功效低、对分组方式敏感,不能当成“模型正确”的证明。
- 报告里的 AUC、准确率、灵敏度全是训练集回代结果,必然偏乐观。 它们衡量的是模型在自己见过的数据上表现如何,不是换一批人能达到什么。本模块没有做交叉验证或外部验证——真要当预测模型用,这一步必须另做。
- 准确率要和“无脑基线”比才有意义。 如果 90% 的人都不复发,一个永远预测“不复发”的模型准确率就有 90%。报告把这个基线算好放在同一张表的表注里,高出来的那几个百分点才是模型的贡献。
- 分类阈值 0.5 是默认值,不是最优值。 灵敏度和特异度的取舍完全由阈值决定;漏诊代价远高于误诊时就该把阈值调低,而不是沿用 0.5 再抱怨灵敏度不够。
检验只能拒绝原假设,不能证明它成立。p = 0.42 既可能是真的没有差别,也可能是样本量不够、差别没被检出来,两者从这个 p 值上分不开。规范的写法是「没有证据表明……」;要论证「两者确实相当」,需要另做等价性检验。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:回归系数表与模型整体检验
- 输出结果三:优势比可视化与 ROC 曲线
- 输出结果四:效应量、拟合优度与分类性能
- 输出结果五:结论与学术表述
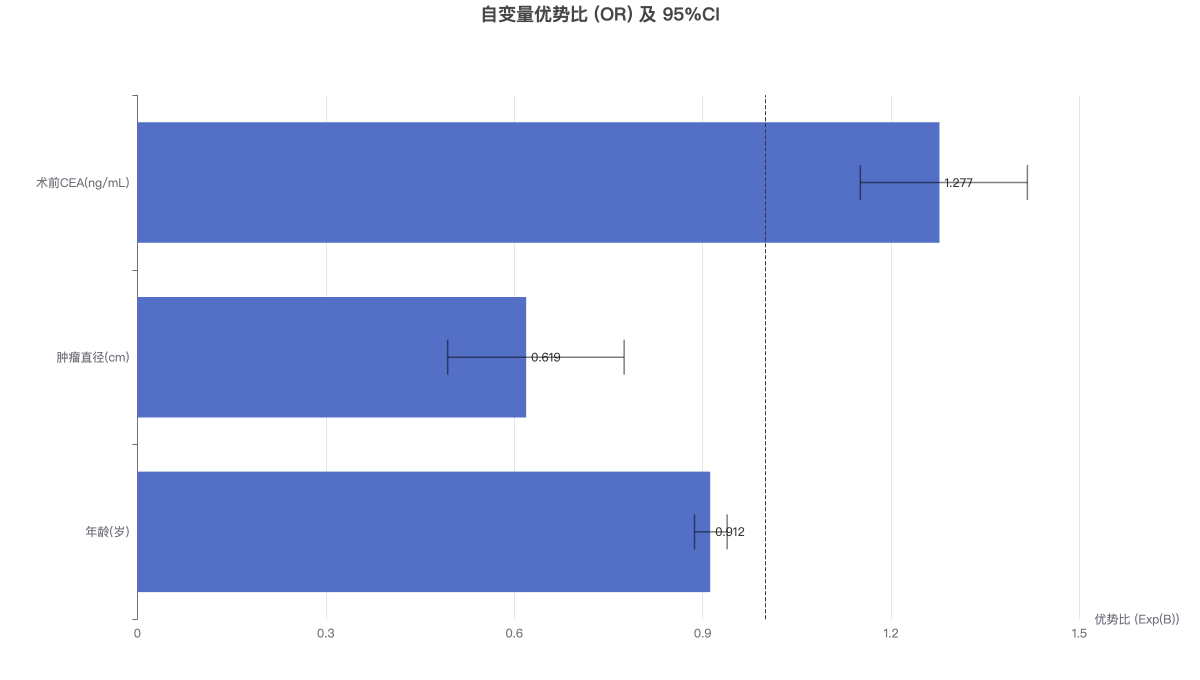
柱高为各自变量的优势比 OR = exp(B),黑色误差线为其 95% 置信区间,虚线为 OR = 1 的无效线;红色(OR>1)为危险因素,绿色(OR<1)为保护因素。可用右上角切换器切到「表格」读取精确数值。
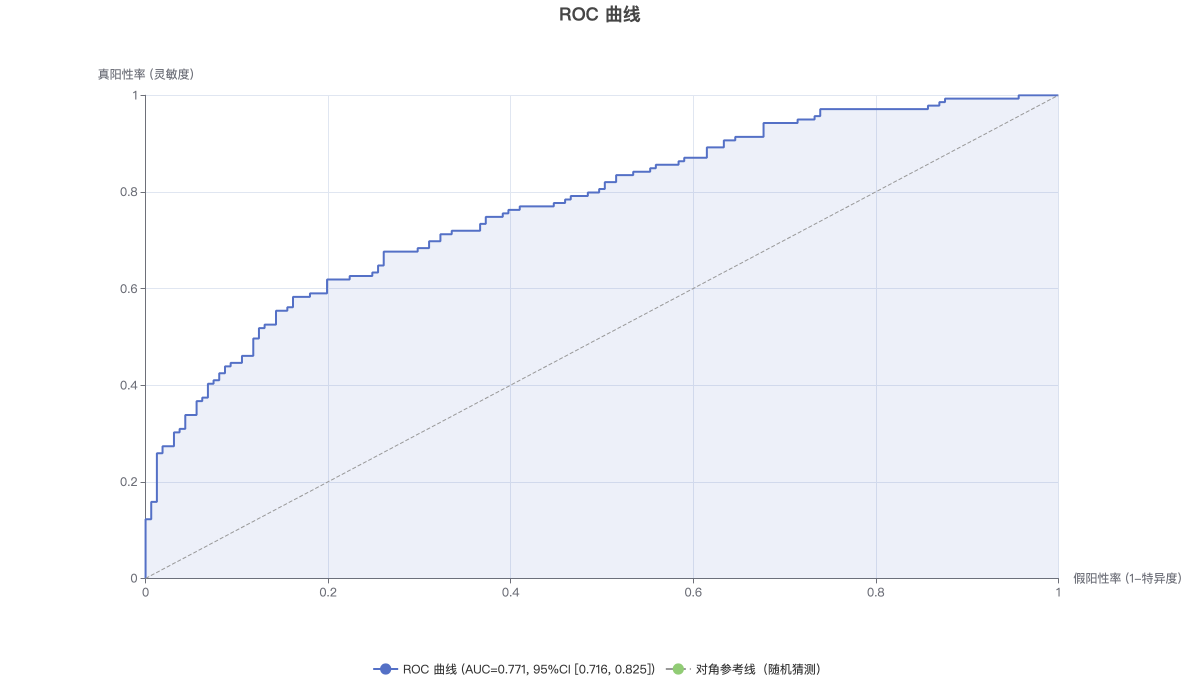
ROC 曲线展示模型在所有分类阈值下的灵敏度与假阳性率权衡;曲线下面积 AUC = 0.771(95%CI [0.716, 0.825],Hanley-McNeil 法),区分能力一般(0.7 ≤ AUC < 0.8)。虚线为随机猜测(AUC = 0.5)。