
线性回归 (最小二乘法)
这个方法是做什么的
用一个或多个自变量去解释一个数值型因变量。每个自变量给出一个系数 B,含义是“在模型里其他自变量保持不变的前提下,这个自变量每增加 1 个单位,因变量平均变化多少”,同时给出它的标准误、t、p 与 95% 置信区间——区间不含 0 与 p 小于 0.05 完全等价,但区间还多告诉你这个效应有多大、估得有多准。
除了系数,报告还给出模型整体的解释力(R² 及其 95% 置信区间、调整 R²、Cohen's f²、回归标准误、AIC/BIC、回归方差分析表)、每个自变量各自的唯一贡献(标准化系数 β、偏 η²、半偏 r²),以及一整套“这些 p 值和置信区间能不能信”的诊断:VIF 共线性、Shapiro-Wilk 残差正态、Breusch-Pagan 同方差、Durbin-Watson 误差独立、Ramsey RESET 设定形式、Cook's D 强影响点。定类自变量可以直接拖进来,本模块会按 drop_first 规则自动做哑变量编码并丢掉一个基准水平。
需要准备什么数据
- 因变量 Y (定量):定量变量(数值)
- 自变量 X (定量/定类):至少 1 个,定量变量(数值)或定类变量(分组/标签)
数据要求
- 数据表至少 20 行。
- 单列缺失率不超过 30%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 想量化“广告投入每多花 1 万元,月销售额平均多几万”这类问题
- 多个因素同时存在时,想分离出每个因素的净关联
- 需要一张可解释、能写进论文的系数表,而不是一个黑箱预测器
什么时候不要用它
- 因变量是“是 / 否”:用「逻辑回归」。
- 因变量是等级(1~5 星、轻 / 中 / 重):用「有序逻辑回归」。
- 因变量是计数(每天的投诉件数):用「计数数据回归」;0 特别多时用「零膨胀计数回归(ZIP/ZINB)」。
- 自变量之间高度相关:系数会变得极不稳定——换一批相似的数据,系数可能大幅变化甚至变号。第一张卡的 VIF 诊断就是查这个的(小于 5 良好、5~10 需关注、10 以上严重),要单独细查用「VIF共线性诊断」,严重时考虑「岭回归(Ridge)」或「Lasso回归」。
- 观测之间不独立(同一批对象的多期数据、同一所学校内的学生):普通最小二乘会低估标准误,把 p 值算得过小。有个体—时间两维结构的用「面板模型」,个体重复测量或分层嵌套的用「混合模型」,只关心总体平均效应的用「广义估计方程(GEE)」。
- 样本量勉强够、自变量却塞了一堆:下方“数据要求”里的行数下限是技术下限,不是统计下限(只要求有效样本数大于“编码后自变量个数 + 1”)。经验上每个自变量至少需要 10~20 个观测,第一张卡会直接给出实测的 n/k。不达标时先用「线性回归功效」按你预期的效应量反推需要多少样本;样本补不上,就用「特征筛选」或「Lasso回归」把自变量压下来,或者用「逐步回归」按统计判据筛选——但要在论文里写明筛选过程,否则 p 值是失真的。
容易误读的地方
- 系数是“控制其他自变量之后”的偏效应,不是这个变量单独的效果。 同一个变量,模型里多放或少放一个别的变量,它的系数会变,极端情况下还会变号。所以“广告投入的系数是 3.58”这句话离开了“模型里还有门店面积和折扣力度”就没有意义——报告时必须把整套自变量一起写出来。
- R² 高不等于预测准。 报告里的 R²、拟合图和各类效应量全部是在训练这批数据上回代算出来的。自变量越多 R² 只会越高(哪怕加进去的是随机数),跨模型比较必须用调整 R² 或 AIC/BIC,而 AIC/BIC 又只在因变量相同的模型之间可比。至于换一批新数据还能不能行,本模块没有评估,需要另做交叉验证或用新样本验证。R² 自己也有 95% 置信区间(由非中心 F 反解得到),区间很宽就说明“解释力有多强”这件事本身还很不确定。
- 各自变量的贡献加起来不等于 R²,这不是算错。 第四张卡的半偏 r² 是把该变量从模型里拿掉时 R² 会掉多少,也就是它的唯一贡献;几个自变量彼此相关时,还有一部分解释力是它们共享的,谁也独占不了。所以半偏 r² 之和通常小于 R²,“占 R² 的比例”那一列加总一般也不到 100%。差额越大说明自变量越冗余、单个系数越不可靠,这时该回头看 VIF 那张表。另外偏 η²(= t²/(t²+残差自由度))与半偏 r² 分母不同、数值不同,判读阈值也不通用,论文里要写清楚报的是哪一个。
- 前提不成立时,先失真的是 p 值和置信区间,不是系数本身。 存在异方差时,B 的点估计仍然无偏,但标准误算错了,于是 p 值和置信区间都不能用。第一张卡的 Breusch-Pagan、Durbin-Watson、Ramsey RESET 与残差正态性检验就是逐条查这个的——注意 Durbin-Watson 没有通用 p 值,按 1.5~2.5 的经验区间读;还要注意那张表里标着“未做”的行表示这项检验本次没执行,不代表前提成立。看到某一项不满足,正确的反应是改模型设定或换一种推断口径,而不是照抄那张系数表。本模块只输出普通 OLS 标准误,没有切换 HC3 稳健标准误的开关:产品内可行的做法是先对偏态的因变量做「数据变换(Box-Cox/Yeo-Johnson)」再重跑,或改用推断不依赖同方差的「分位数回归」。
- 系数只在你观测到的自变量取值范围内有意义。 样本里门店面积是 20~355 平米,就不要拿这个模型去推 1000 平米的店会怎样。第一张卡的描述统计给出了每个变量的最小值与最大值,外推之前先看一眼。
- 整体 F 显著不代表模型是对的。 F 检验的原假设只是“除截距外全部系数同时为 0”,拒绝它只说明至少有一个自变量有用;模型设定对不对是另一回事,由 Ramsey RESET 回答。同样地,Cook's D 大于 4/n 的强影响观测有几个、最大值多少,第一张卡都列了出来——数量偏多时应当做一次剔除后的敏感性分析,而不是直接采信。
- 回归系数不是因果效应。 “控制了其他变量”控制的只是你放进模型的那些。任何一个没放进去、又同时影响 X 和 Y 的变量,都会让系数偏掉,而报告里看不出来。要做因果解读靠的是研究设计(随机化、工具变量、断点),不是往模型里多塞几个控制变量。
看到 r = 0.62,X 导致 Y、Y 导致 X、第三个变量同时影响两者、纯属巧合这四种情况都可能,相关系数本身分不清它们。能分清的是研究设计——随机化、工具变量、断点,而不是往模型里多塞几个控制变量。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:回归系数与模型整体检验
- 输出结果三:拟合效果与残差诊断图
- 输出结果四:效应量与方差分解
- 输出结果五:结论与学术表述
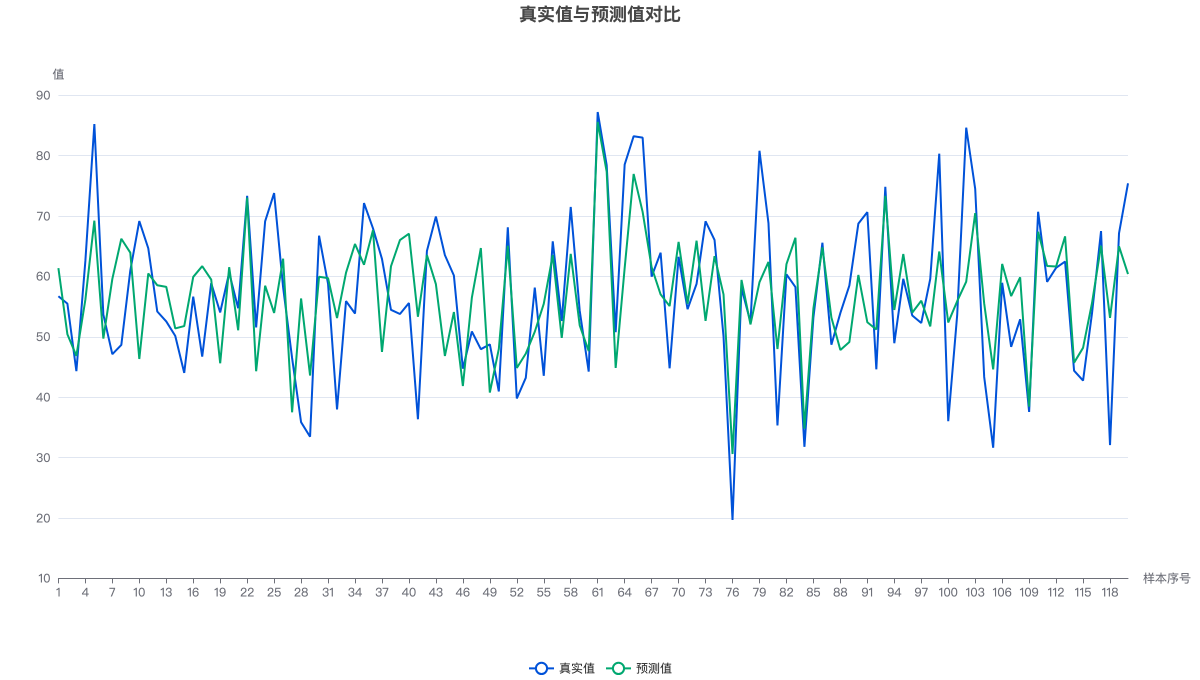
蓝线为样本真实值,绿线为模型预测值,横轴为样本序号。可用右上角切换器切到「表格」逐点读数。
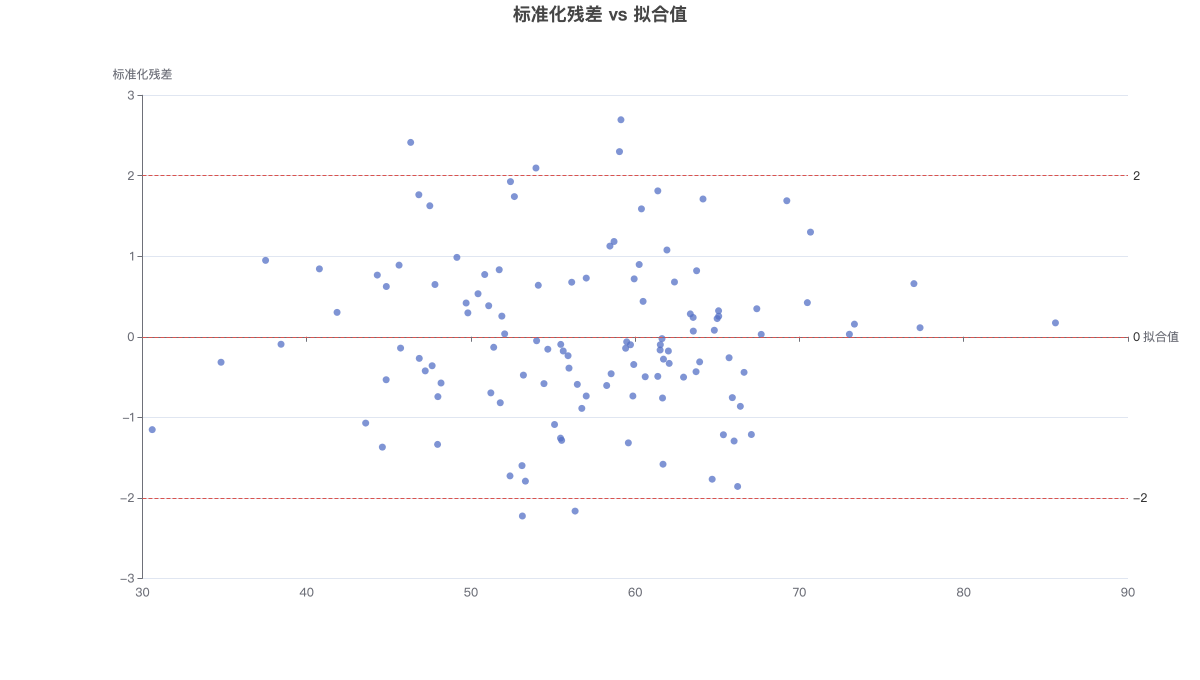
横轴为模型拟合值,纵轴为标准化残差;红色虚线为 0 与 ±2 参考线。理想情况下散点应在 0 线上下无规律地均匀散布。