
信度分析
这个方法是做什么的
回答一件事:一份量表里的若干道题,是不是在稳定一致地测同一个东西。核心指标是 Cronbach's α,取值 0~1,越高说明题项之间越一致、测量误差越小。评级沿用 Nunnally(1978):0.9 以上极佳、0.8~0.9 良好、0.7~0.8 可接受、0.6~0.7 偏低、低于 0.6 不可接受。
报告除了 α 及其 Feldt 法 95% 置信区间,还给出标准化 α、McDonald's ω(total)、Guttman λ6 与枚举全部折半方式后取最大的 λ4,以及平均题间相关 r̄、与总分同量纲的测量标准误 SEM、每道题的校正题总相关(CITC,含置信区间与 Holm 校正后的显著性)和“删掉这道题之后 α 会变成多少”。第一张卡还会把 α 的七条前提逐条实算一遍:题项数、各题方差是否为 0、有没有反向题残留、r̄ 是否落在 0.15~0.50、单维性(第一与第二特征值之比)、本质 τ-等价(单因子载荷的极差)、样本量与题项数之比。
需要准备什么数据
- 放入[定量]量表题项:至少 2 个,定量变量(数值)
数据要求
- 数据表至少 30 行。
- 单列缺失率不超过 20%。
- 不接受取值全都一样的列(零方差列没有可分析的变异)。
以上条目由系统从该方法的校验规则直接生成,与上传数据时的实际拦截规则一致。
什么时候用它
- 自编或改编问卷之后,检验各维度的内部一致性
- 论文的方法部分需要报告量表信度
- 想找出哪几道题拖累了整份量表
用法上有一条关键:一次只放同一个维度的题。题项至少 2 道(做删项诊断建议 3 道以上),样本量建议不少于题项数的 5 倍且不低于 30。缺失按列表删除处理——任一题缺失就整条剔除,为的是让协方差矩阵基于同一批被试。
什么时候不要用它
- 把整份问卷所有题一起放进去:如果问卷包含服务质量、产品体验、价格感知三个维度,应该分三次跑,每次只放一个维度的题。混在一起算出来的 α 没有解释意义(原因见下方第三条)。不确定实际有几个维度、每个维度包含哪些题时,先用「因子分析(探索性)」把结构跑出来,按载荷把题分组,再逐组回来算信度。
- 量表里有反向计分题而你还没做反向处理:会拉低甚至拉负 α。第一张卡用“负的 CITC 题项数”与“负相关的题对数”来提示这一点,但反向处理本身要先在“数据处理”里完成,处理完再回来重跑。拿不准哪几道题是反向的,可以用「因子分析(探索性)」看载荷符号——同一维度里符号相反的那几道就是没转过来的。
- 你想问的是“这份量表测的到底是不是那个构念”:那是效度问题,用「效度分析」或「因子分析(探索性)」。
- 题项是单选、多选这类分类题,不是可以加总的评分:α 只用到方差与协方差,对无序类别没有意义。想看各选项的分布与组合用「多选分析」,想看两道题之间的关联用「列联(交叉)分析」,多位评分者给同一批对象贴分类标签、要判断他们一致不一致则用「Kappa一致性检验」。对错题这类 0/1 计分是可以直接放进来的——此时 α 恰好等于 KR-20,但别把 0/1 题和李克特题混在一次里算。
容易误读的地方
- α 高不代表量表有效。 信度只说明题项彼此一致,不说明它们测的是你想测的东西。八道题全是“你今天心情如何”的不同说法,α 会很漂亮,但它测不出满意度。信度是效度的必要条件,不是充分条件。
- α 会随题项数机械上升。 在题项之间的平均相关不变的前提下,题越多 α 越高。所以 20 道题的 α = 0.90 完全可能比 5 道题的 α = 0.80 更“水”。报告 α 时必须同时给出题项数与平均题间相关 r̄——后者才是同质性的纯净度量,不随题目多少变化,第四张卡有这个值,并给了 0.15~0.50 的参考区间:低于下限说明这些题根本不同质,高于上限则说明题目彼此高度重复、量表冗余。
- α 假定这些题只测一个维度。 拿一份多维问卷整体算 α,数值再高也解释不了什么:几个维度各自内部一致,混在一起同样能把 α 顶上去。第一张卡用第一特征值与第二特征值之比来体检单维性(经验判据是比值不低于 3,同时看第一成分的解释率),跑之前先看它。同一张表还查了另一条更严格的前提——本质 τ-等价,即各题的单因子载荷是否接近(极差不超过 0.20);不成立时 α 会低估真实信度,此时应优先报告不要求 τ-等价的 McDonald's ω。
- 主结果表里那个 p 值不是“信度达标”的检验。 α 那一行的 F 检验,原假设是 α = 0,也就是“题项之间毫无共同方差”,F = 1/(1−α̂)。这是个极低的门槛:α 只要有零点几,它就必然显著。它回答不了“信度有没有到 0.7”这个真正的问题——那要看点估计,更稳妥的是看 Feldt 95% 置信区间的下限是否越过了 0.7。把这个 p 小于 0.001 写成“信度显著良好”是常见的误报。
- 不要因为“删掉这道题 α 会升高”就删题。 第四张卡给出的删除后 α 是在这一批样本上算的,提升往往只有零点零几,而删题会实实在在削掉量表的内容覆盖面。模块给的建议修订规则是三条并列——CITC 低于 0.30、Δα 大于 0、或 CITC 经 Holm 校正后不显著——但那只是提示,删题必须先有理论上的理由(题意重复、表述有歧义),α 只能当辅助证据。
- α 是这批被试的属性,不是量表刻在身上的常数。 机制在公式里:α 的分母是总分方差,而总分方差取决于这批人彼此差多少。同一份量表拿去测一群更同质的人(只招高分段、只测某一个科室),题间协方差相对题内方差缩水,α 必然掉下来——这时低的是这次施测的信度,不是量表变差了。所以别人论文里的 α 不能直接引用成自己数据的信度,自己的 α 也要连同样本构成、N 与题项数、r̄ 和置信区间一起报告。要一个跨样本更好沟通的说法,用第四张卡的 SEM = 总分标准差 × √(1−α):它与总分同量纲,个体真分数的 95% 区间约等于观测总分 ± 1.96×SEM,直接告诉你这份量表把一个人的总分测到了什么精度。
报告里有什么
- 输出结果一:数据概览与前提检验
- 输出结果二:信度主结果表
- 输出结果三:可视化(题项诊断图与信度仪表盘)
- 输出结果四:效应量与事后分析
- 输出结果五:结论与学术表述
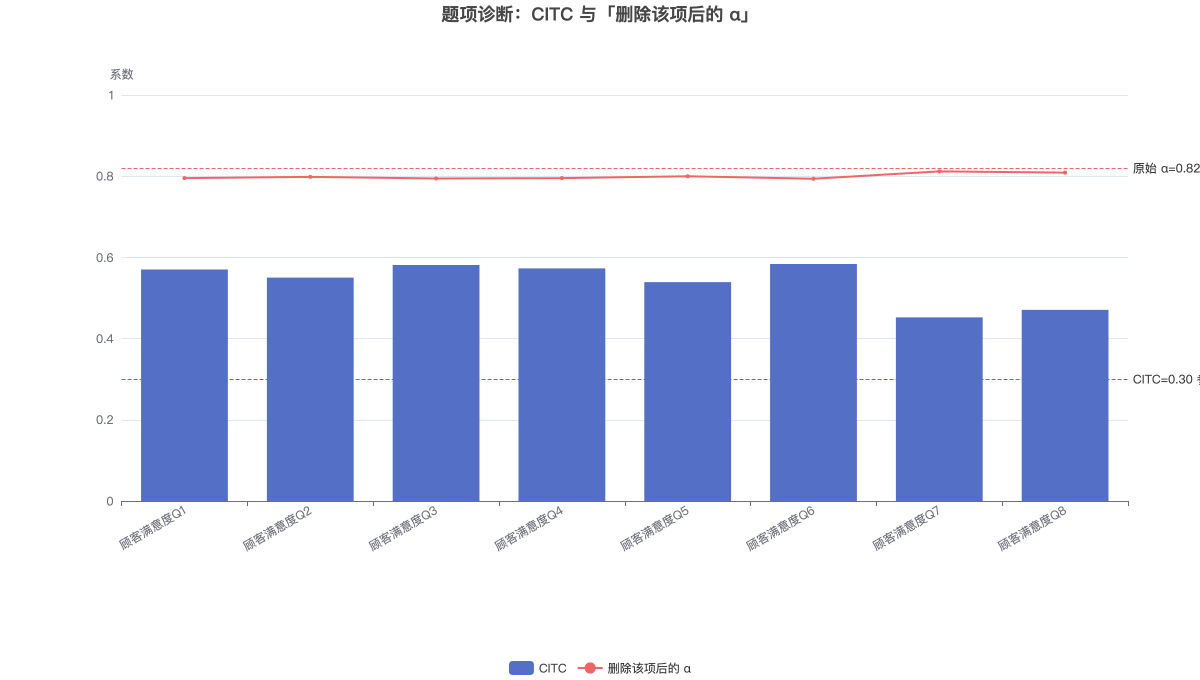
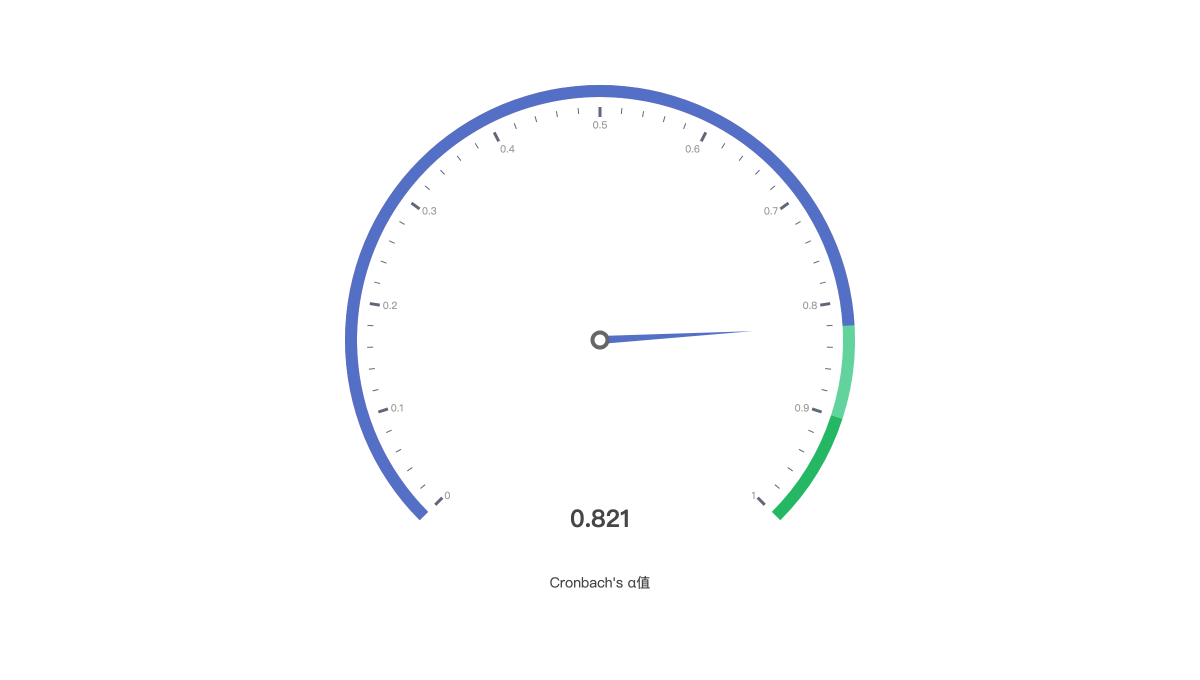
上图可用左上角切换器在柱状图/条形图/折线图/数据表之间切换;下方仪表盘给出整体信度定位。
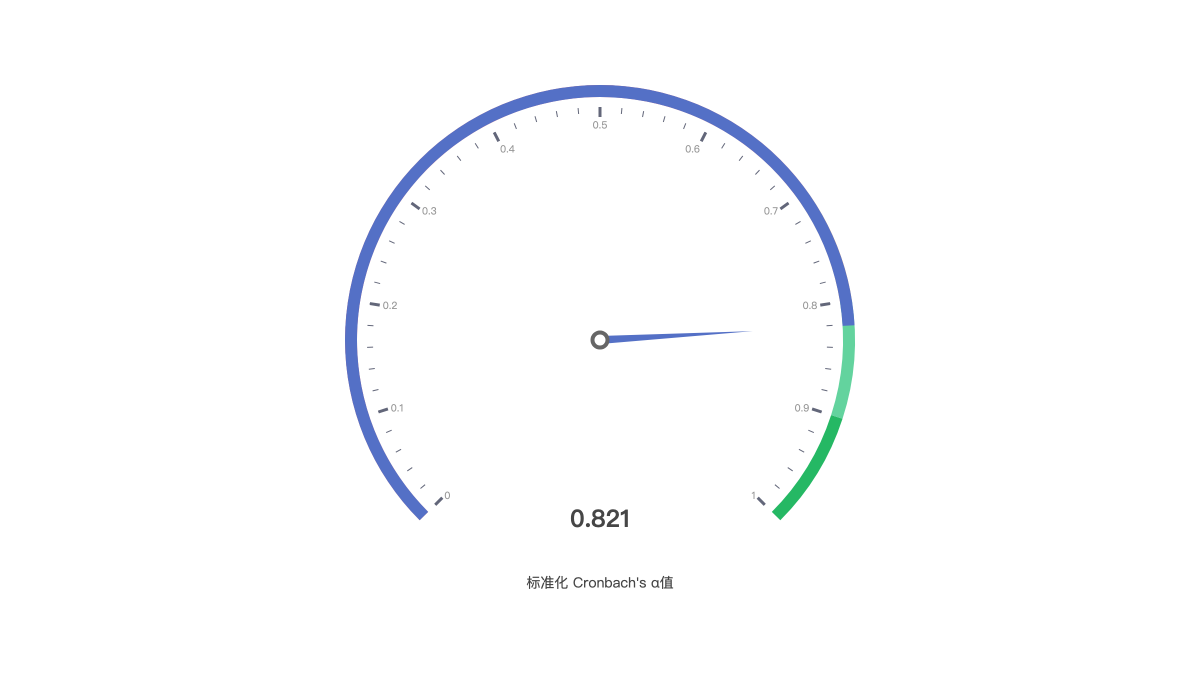
上图可用左上角切换器在柱状图/条形图/折线图/数据表之间切换;下方仪表盘给出整体信度定位。