SPSS 描述性统计和推断性统计的区别:论文里各写什么
更新于
描述性统计和推断性统计的区别在于结论对象:前者说明当前样本有什么特征,后者在抽样与模型条件下讨论总体参数或假设。论文通常先描述样本,再按研究问题安排推断分析;描述表里的分布检验只是辅助体检,尚未检验研究中的组间差异或变量关系。
描述统计与推断统计容易混在哪
当一份报告既有平均值、标准差,又有正态性检验和均值区间时,容易把整份报告当成已经完成研究假设检验。较清楚的读法是逐项问:这个数针对样本分布、总体均值,还是某项事先提出的比较?同一报告可以包含不同性质的统计元素,方法名称并不会抹平这些差别。
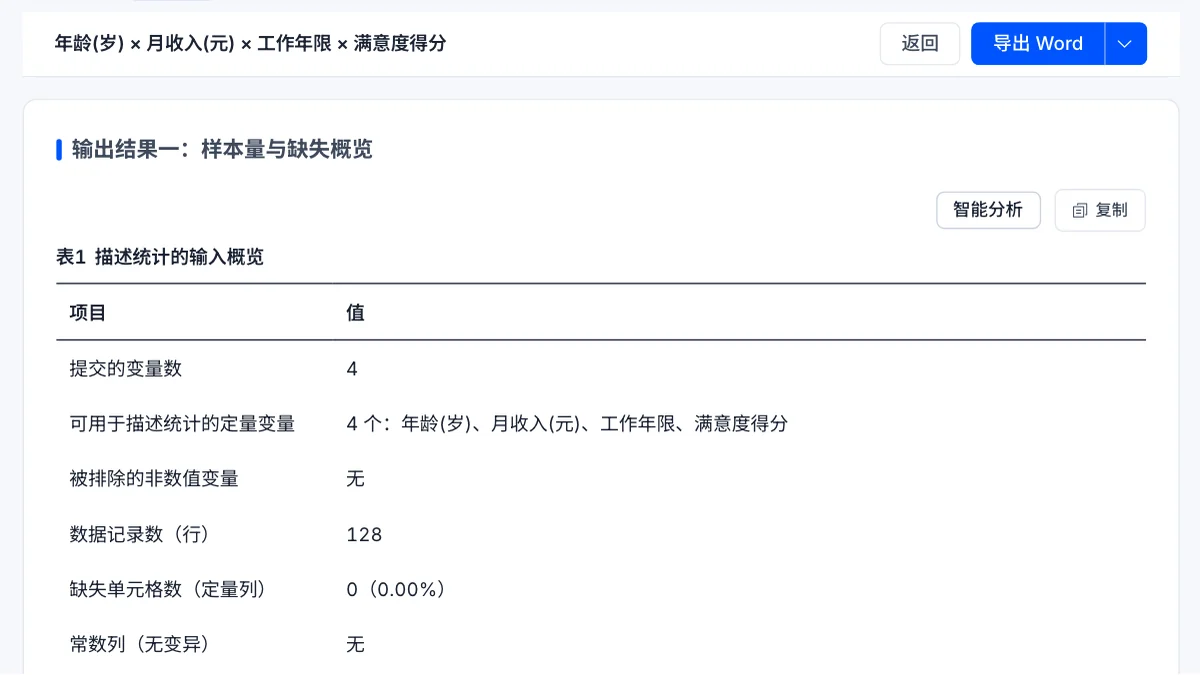
以下使用本站演示数据(模拟生成,不代表真实研究结论),从原始 150 行随机抽取 128 行,随机种子 103。参与的变量为年龄、月收入、工作年限与满意度得分,全部保留本次抽取后的记录;它们适合说明样本基本面,但没有在本场景中设置某个分组或回归关系。方法说明见描述性统计。 复现时从原演示表表头后的首条数据行起计,移除第 1、4、5、8、11、14、39、53、55、74、83、84、99、100、101、112、115、121、128、142、147、149 行,保留其余行的原顺序并另存上传;工作台不会自动按本文种子抽样。
| 阅读对象 | 主要回答 | 本例可找到的材料 |
|---|---|---|
| 样本特征 | 观察到哪些值与分布 | 有效数量、均值、中位数和图形 |
| 估计精度 | 总体参数估计有多不确定 | 均值标准误及置信区间 |
| 研究假设 | 是否存在指定差异或关系 | 当前场景未执行相应检验 |
为什么一张描述表不足以回答研究问题
抽样方式决定样本和目标总体的关系,模型则规定如何描述差异、关联及其不确定性。即使收集了大量数据,如果样本来源带有选择偏差,单凭均值区间变窄也无法消除该偏差;同理,有效样本数量只是判断推断基础的一部分,并不能单独保证总体代表性。
本次年龄均值为 38.859,标准差为 11.250,中位数为 37.000。这些统计量概括当前样本的集中与分散;其中标准差描述个体差异,均值的标准误则关注平均值在抽样中的波动,它们即使写在同一张表里,也仍然对应不同问题。
区分两类结论的解决步骤
- 先写清研究对象和问题:是描述这批样本,还是估计目标总体、比较组别或考察关系。
- 在「描述性统计」中载入相应数据,核对有效数量、缺失和分布,选择适合变量尺度的摘要方式。
- 如需推断,依据结局类型、独立或配对结构与研究假设另行安排方法;当前场景的描述结果保留为样本背景。
描述性统计和推断性统计的区别:怎么确认
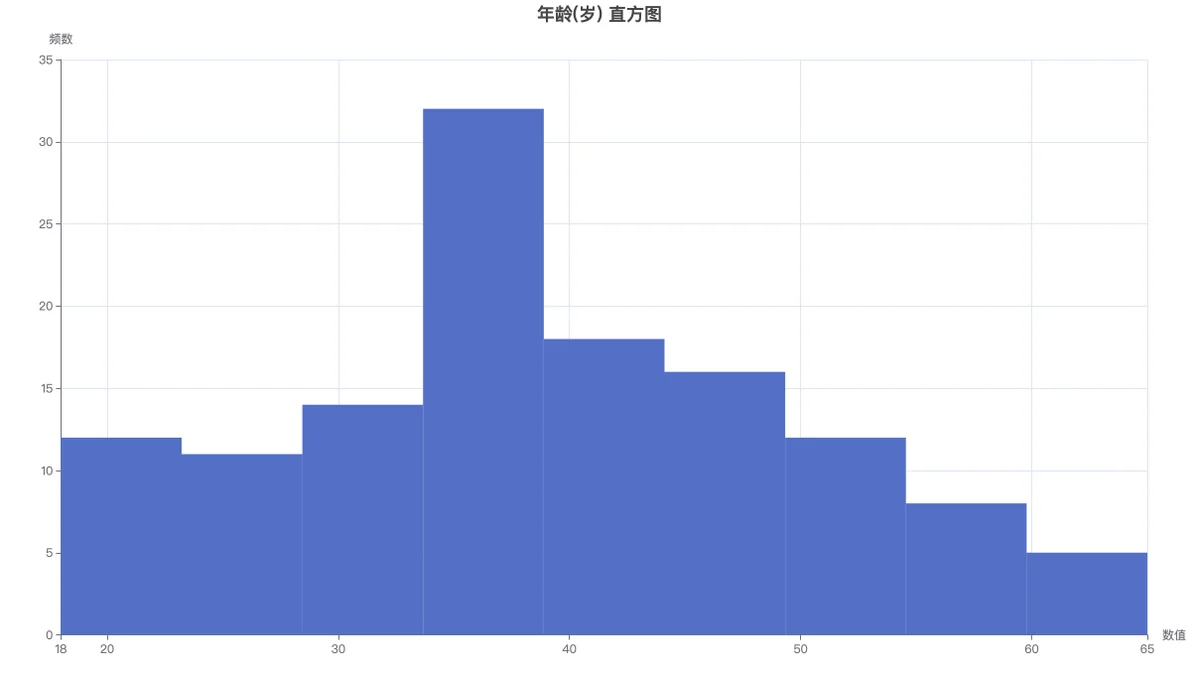
直方图先回答年龄值集中在哪些区段、两端分布怎样,并不直接比较任意人群差异。图形与均值、中位数共同帮助选择表达方式;若要推断两个群体的年龄差异,还需要有分组变量及相应估计或检验,本图没有执行这一步。
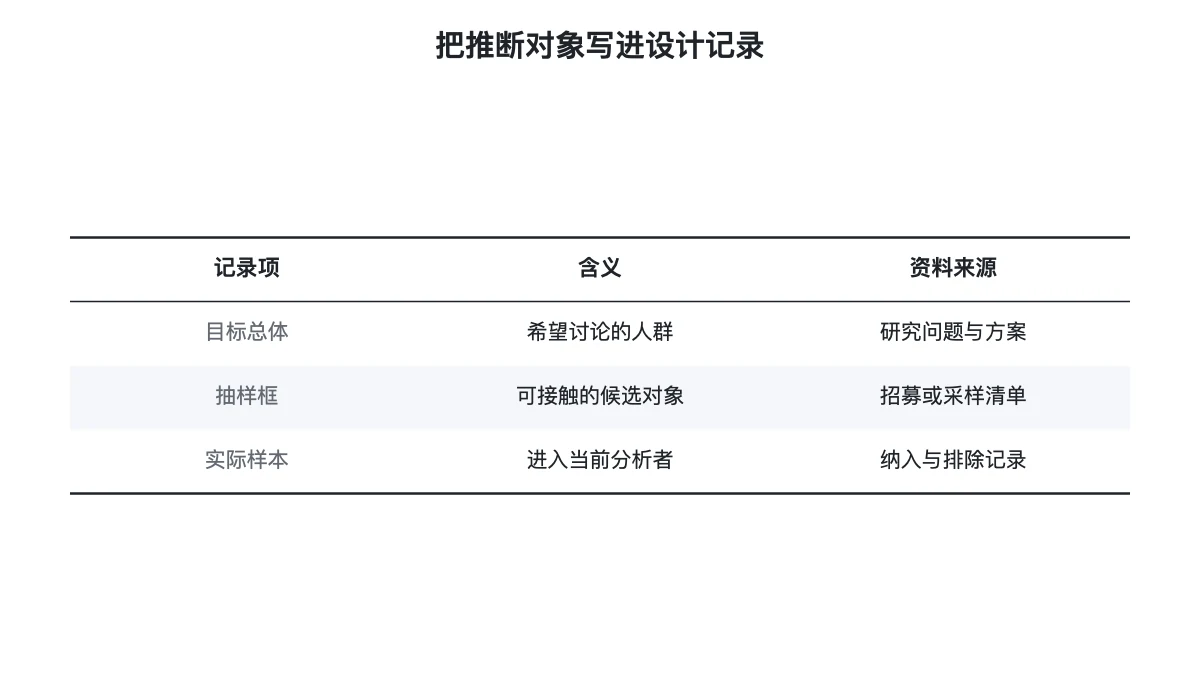
图中是一份设计信息记录模板,使用时由研究者依据招募与纳入文件填写,而不是从描述报告里猜测这些信息。登记完成后可附上清单版本及保管位置,让读者核实结论针对谁;出现一个 p 值,并不会让任意研究命题自动获得支持。
报告对某些列做了 Shapiro-Wilk 检验,未显著表示本次检验未发现相应分布偏离,而非证明分布成立。对于因样本或常数列原因未执行的检验,应记录为未检验;缺失结果与得到一个较大的 p 值是两种不同状态,论文中也应保留区别。
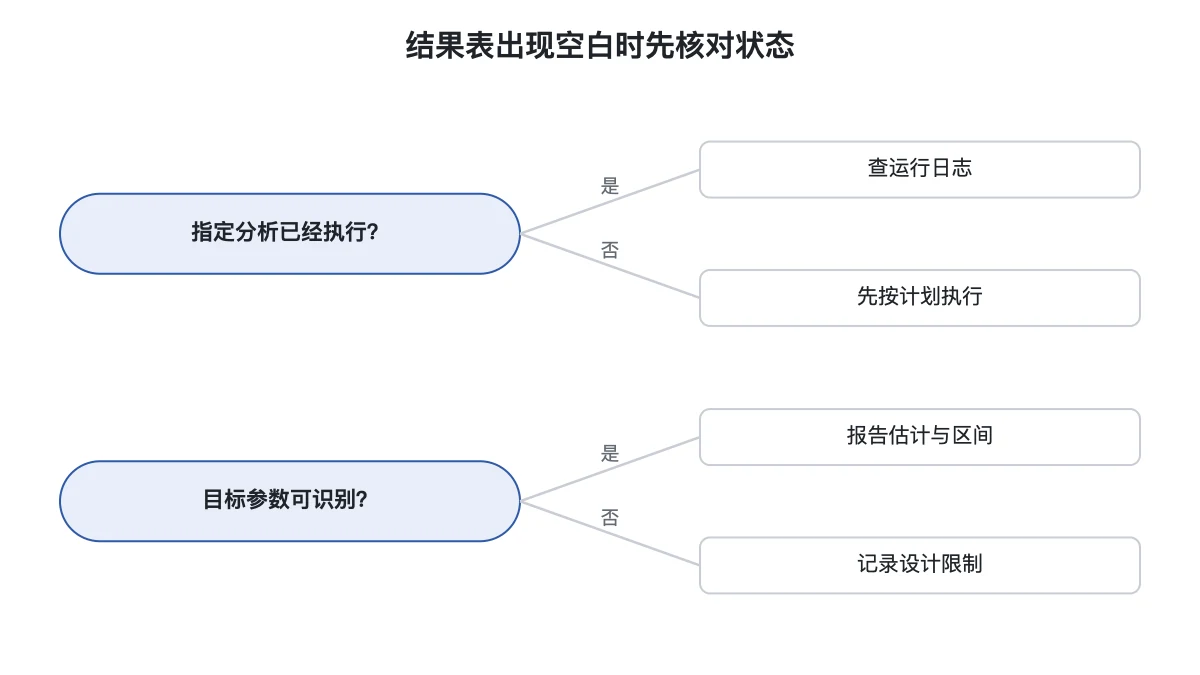
正式写作时,样本特征表可列出变量单位、有效数量、摘要统计与缺失口径。推断结果则另列效应估计、区间、检验及模型设置;若研究只做现状描述,保持描述性结论就能回答问题,无需为了让表格显得复杂而加入无关检验。
常见混淆还包括把置信区间写成大部分人的取值范围,或把样本中的排序写成总体规律。前者需回到分位数和个体分布,后者则需明确抽样与推断依据;将结论限定在实际分析支持的层面,可以保留发现的价值,也便于他人复核。
开通会员后可导出 Word / PDF 报告、使用 AI 解读。保存结果时也请保留数据来源和分析设置,便于后续核查。
描述表与推断模型应能追溯到同一数据版本,记录筛选条件和缺失处理,避免分析对象不一致。
延伸阅读
常见问题
- 描述性统计和推断性统计的区别是什么?
- 描述性统计整理已观察样本的特征,推断统计则在抽样和模型假设下估计总体参数或检验假设。判断依据是问题与结论对象,不能只看表中有没有p值。
- 描述统计报告中的正态性p值算研究结论吗?
- 该检验考察变量分布是否偏离正态,用于辅助选择摘要方式。它没有检验组间差异、变量关联或干预效果,研究假设需要使用对应的模型和设计另行分析。
- 均值区间能表示个体取值范围吗?
- 均值的置信区间描述估计总体均值的精度,个体分布可用标准差、分位数和图形概括。两种范围针对的对象不同,报告时应明确名称和计算口径。