SPSS 判别分析怎么做:判别函数与分类准确率
更新于
判别分析要先有分组:已知客户分成哪几档,再找出几个定量指标的线性组合,让各组在这条组合轴上分得最开。这条轴叫判别函数(也叫典范判别函数),本站「线性判别分析」同时给出显著性检验、判别载荷和三种口径的分类准确率。下面用 240 例的客户分层演示数据,说明各部分怎么读;做过 SPSS 判别分析的读者,会认出 Wilks' Λ、结构矩阵这些常见报告项。
已知分组适合什么问题
这里的问题以已知标签为起点。例如已有客户分层,需要考察消费、登录和工单信息是否包含区分这些标签的线性信息,并评估分类表现。方法说明见线性判别分析。判别变量必须全是定量列,分组变量为 2 到 10 组,每组至少 5 例,整表至少 30 行。
| 列名 | 角色 | 放进哪个区 |
|---|---|---|
| 客户分层(成长型/流失风险/高价值) | 分组 | 分组变量 (Y) |
| 近12月消费额、月均登录次数、客服工单数 | 判别变量 | 判别变量 (X,多选) |
以下结果来自本站演示数据(模拟生成,不代表真实研究结论):有效样本 240,3 组各 80 例,3 个判别变量,剔除缺失 0 行。按「训练集比例」70% 划分,训练集 168 例,测试集 72 例。
典范函数、显著性检验、结构矩阵与散点图使用全部 240 例;Fisher分类规则与留出测试则使用上面的训练与测试拆分。它们承担不同任务,报告时应分别标明样本基础。
判别函数怎么建立:三步
- 在方法列表里选「线性判别分析」,分组列放进「分组变量 (Y)」,定量指标放进「判别变量 (X,多选)」。
- 在「训练集比例」里设定拆分比例,本例输入小数 0.7,表示 70%。
- 点开始分析,依次读前提检验、判别函数、分类效果和论文表述。
判别函数怎么读
先看前提。每组样本量 80 多于判别变量个数 3;Box's M 检验 p=0.506,未检出协方差不齐的证据;判别变量间最大相关 |r|=0.154,这项成对相关诊断未显示很强的线性联系。组内正态性在 9 项 Shapiro-Wilk 检验中拒绝了 4 项,判定为部分违背,其中三项出自客服工单数这个整数计数变量,本来就很难期待它正态。
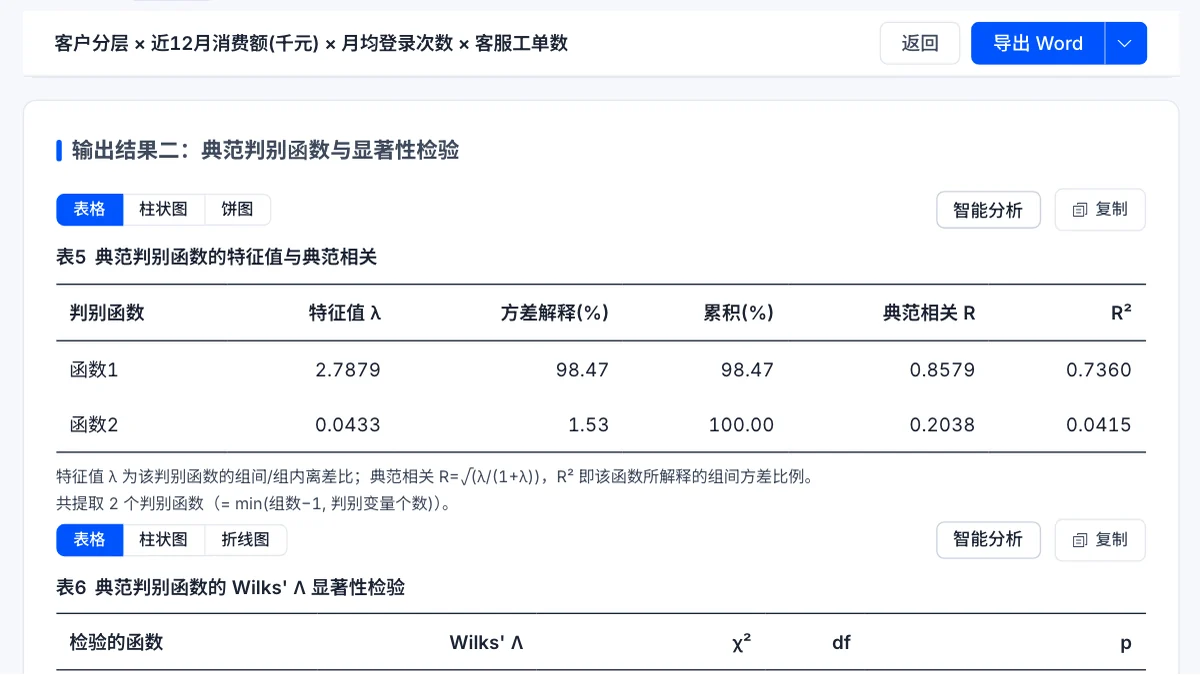
再看判别函数。函数 1 的特征值 2.7879,解释 98.47% 的组间方差,典范相关 R=0.8579;函数 2 的特征值只有 0.0433,占 1.53%。整体检验 Wilks' Λ=0.2530,χ²(6)=324.320,p<0.001,多变量 η²=0.7470,效应量大。
函数 2 的检验同样显著(p=0.007),但这只说明检出了额外的组间区分信息,实际用途仍要结合解释比例和分类表现。第二轴上的样本重叠程度可以辅助判断,但不应把显著性直接等同于应用价值。
结构矩阵比标准化系数更适合解释函数含义。函数 1 上,近12月消费额载荷 −0.6626,月均登录次数 −0.5967,客服工单数 0.4207,习惯上 |载荷|≥0.30 视为有实质贡献。载荷的正负要结合各组质心读:流失风险的质心为 2.067,高价值为 −1.995,成长型为 −0.071,所以这条轴是越大越像流失风险。
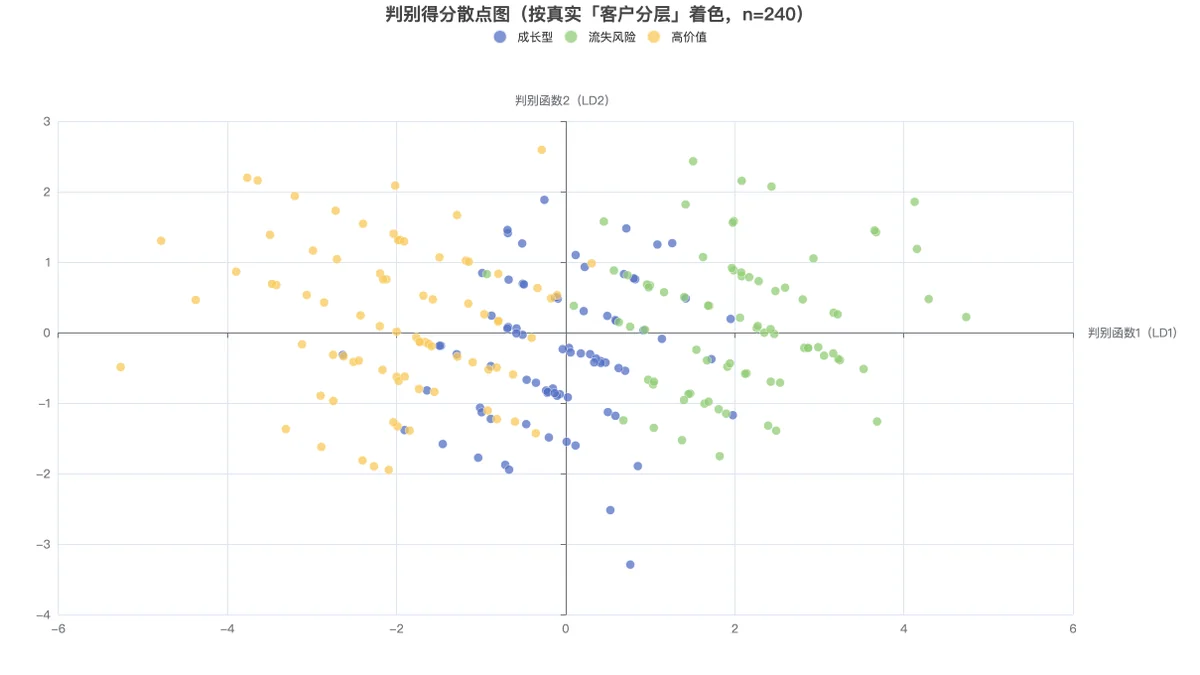
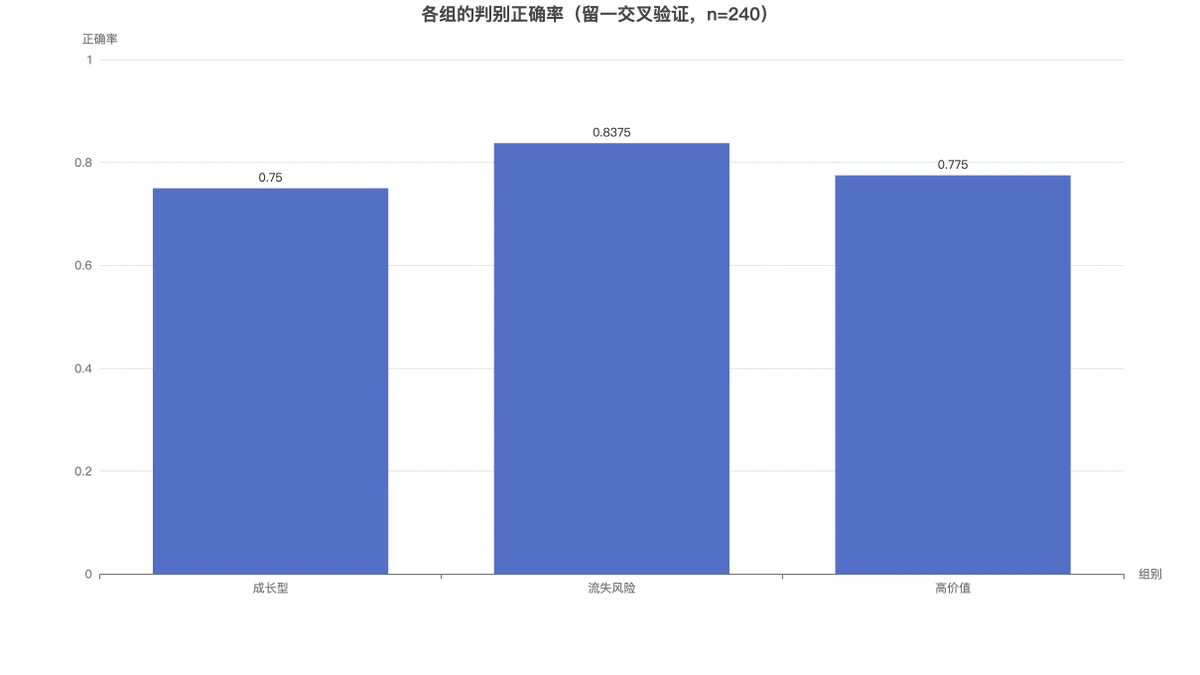
散点图描绘观测在判别轴上的位置,重叠区域提示边界附近可能发生误判。各组分类正确率的柱形图补充类别层面的表现,两个图各自回答分离形态与预测表现的问题。
分类准确率:报告时保留验证口径
报告给出三种口径的分类效果:
| 评估口径 | 总正确率 | 95%CI | Cohen's κ |
|---|---|---|---|
| 训练集回代(n=168) | 0.8274 | [0.7631, 0.8770] | 0.7411 |
| 独立测试集(n=72) | 0.7917 | [0.6843, 0.8695] | 0.6875 |
| 留一交叉验证(n=240) | 0.7875 | [0.7314, 0.8345] | 0.6813 |
训练集回代通常有偏乐观的倾向,规范的报告应明确报告验证口径。本例留一验证比回代低 0.0399,这是两种评价口径的观测差值,混合了训练规模、评价程序与抽样波动,不能当作精确的偏倚估计。混淆矩阵也是留一口径:成长型 60 例判对、流失风险 67 例判对、高价值 62 例判对,各组正确率依次为 0.7500、0.8375、0.7750。流失风险组最准,成长型与高价值之间的混淆较多。
论文里怎么写
采用线性判别分析检验 3 个定量指标对 3 个客户分层的判别能力(N=240)。Box's M 检验未检出协方差不齐(p=0.506)。共提取 2 个判别函数,整体 Wilks' Λ=0.2530,χ²(6)=324.320,p<0.001,多变量 η²=0.7470;函数 1 的典范相关 R=0.8579。留一交叉验证的总正确率为 0.7875,κ=0.6813。
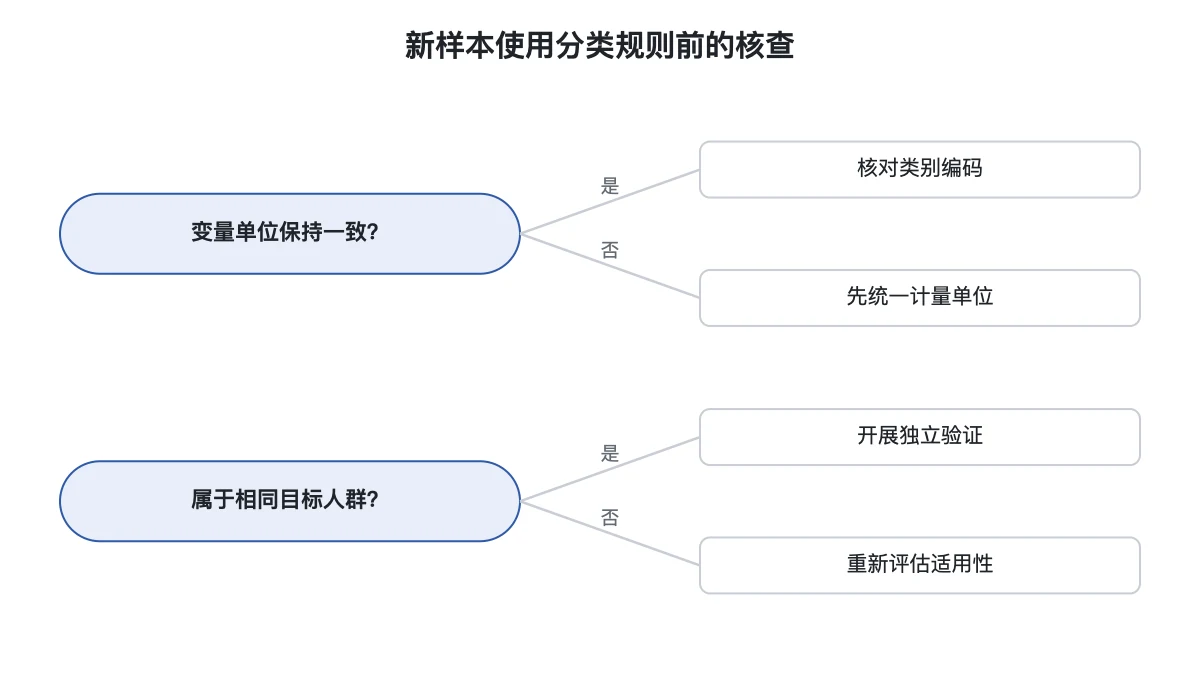
这项分析建立的是分类规则而非因果关系;留一交叉验证属内部验证,要声明规则可推广,仍需在独立样本上验证。
分类规则的常见错误
- 报训练集回代的正确率:只报回代难以评估泛化,需标明内部验证与测试口径。
- 凭系数正负判断方向:轴的方向任意,要看质心表。
- 把 Box's M 的结果当作定论:它对非正态和大样本极敏感,要结合样本量与正态性一起读。
- 判别变量含定类列:判别变量区只收定量列。若预测列包含类别信息,可另行核对「逻辑回归」或「CHAID决策树」。
开通会员后可导出 Word / PDF 报告、使用 AI 解读。正式报告仍需保留分析对象、设置与验证口径,使读者能回到原始研究问题核对。
延伸阅读
常见问题
- 判别分析的判别函数有几个?
- 最多 min(组数−1, 判别变量个数) 个。本例 3 个组、3 个判别变量,可提取 2 个判别函数:函数 1 解释 98.47% 的组间方差,函数 2 只解释 1.53%。
- 线性判别分析的分类准确率该报哪一个?
- 应明确报告验证口径。本例训练集回代 0.8274,独立测试集 0.7917,留一交叉验证 0.7875;回代用于拟合样本,内部验证更适合考察泛化;独立测试也值得报告。
- 判别函数的系数正负代表什么?
- 正负方向是任意的,全部取反并不改变任何统计量。要判断轴的方向,看各组质心:本例函数 1 的质心是流失风险 2.067、成长型 −0.071、高价值 −1.995,所以这条轴是越大越像流失风险。